- 2026年7月に公開されたサーベイ論文は、GEOの研究45本を整理した。研究の多くは、AIの手元にあるページの使われ方しか見ておらず、「書き方で40%上がる」も一般論としては成り立たないとした
- 根拠がいちばん強いのは、質問と内容が合っていることと、AIが読む検索結果のリストで上にあること。引用を狙った書き直しは、検索で拾われる段階で不利になることもある
- いちばん確かなのは、想定される質問に、はっきり答えるコンテンツを持つこと。そのうえで、AIの答えは聞くたびに変わるので、「挙がったか」「引用されたか」「正しく伝わったか」を分けて繰り返し測る
こんにちは、アースダイバー代表の佐藤です。AIが広がって、ウェブマーケティングは取るべき戦略も、実行のやり方も変わりました。アースダイバーは、その新しい前提で戦略を考え、実行する仕組みまでつくる会社です(ご相談はこちら)。
AI検索対策(AIO・LLMO・GEO)のノウハウは、この1年で一気に増えました。こういう書き方をすればAIに引用されやすい、といった話もよく見かけます。ただ、その多くは「なぜ効くのか」「どこで確かめられたのか」がはっきりしません。
2026年7月、この疑問を検証した論文が公開されました。主に2023年11月から2026年7月までに世界で発表されたGEOの研究45本を集めて、「何が確かめられていて、何がまだ言えないのか」を整理したものです(Martinez, 2026)。このように、たくさんの研究をまとめて全体像を示す論文を「サーベイ」と呼びます。
著者はOlivier Martinez氏です。海外では、公開から数日でマーケティング業界のニュースサイトPPC Landが取り上げ、この論文の主な貢献は、施策のリストより「何をもって効果ありとするか」の基準と測り方を示したことだと紹介しました。AIでの見え方の診断を手がける会社AskedAboutも、自分たちの業界に厳しい内容だと認めたうえで、繰り返し測ることを勧める記事を出しています(AskedAbout)。
この記事では、このサーベイを順番に読みながら、ひとつずつ「それは、実務ではどういうことか」をかみ砕いていきます。後半で、BtoB企業のマーケティング担当者が明日から何をすればいいかを、具体例つきでまとめます。
先にひとつだけ。この論文は、専門家による審査(査読)を経る前の段階で公開されたもので、紹介されている研究にも、審査前のものや企業がお金を出したものが含まれます。「いま時点で、研究者がここまで整理した」という前提で読んでください。
目次
- 1論文の前提:AIが答えるまでには7つの段階があり、施策を試す研究の多くは真ん中の段階で効果を測っている
- 2「書き方の工夫で40%上がる」は、最初からAIに渡した5ページの中での話だった
- 3効くと確かめられているのは、問いに合っていることと、AIが読むリストの上のほうにあること
- 4みんなが同じ工夫をすると、効果は薄れていく
- 5引用を狙って書き直すと、かえって検索で拾われにくくなることがある
- 6AIの答えは、聞くたびに、AIごとに変わる
- 7AIに「知られている」ことと、「勧められる」ことは別の話
- 8AIは、引用元の内容を正しく伝えているとは限らない
- 9AIに引用されると売上が増えるのかは、まだ確かめられていない
- 10読み解き:サーベイが勧めるのは「問いに答える、確かめられる、拾われるページ」と「分けて測ること」
- 11このサーベイの限界:効果の大きさは統合しておらず、査読前の研究も多い
論文の前提:AIが答えるまでには7つの段階があり、施策を試す研究の多くは真ん中の段階で効果を測っている
まず、このサーベイがAI検索をどう捉えているかです。ここを押さえると、あとの話がぐっとわかりやすくなります。
AI検索対策というと、「AIの答えの中で、自社が何位に出るか」をイメージする人が多いと思います。Martinez氏は、そう単純な話ではないと言います。AIが答えを返すまでには、いくつもの段階があって、それぞれで落ちる可能性がある。しかも、同じ質問をしても、毎回同じ結果になるとは限らない。そこで、45本の研究を「どの段階を調べたものか」で仕分けしています。
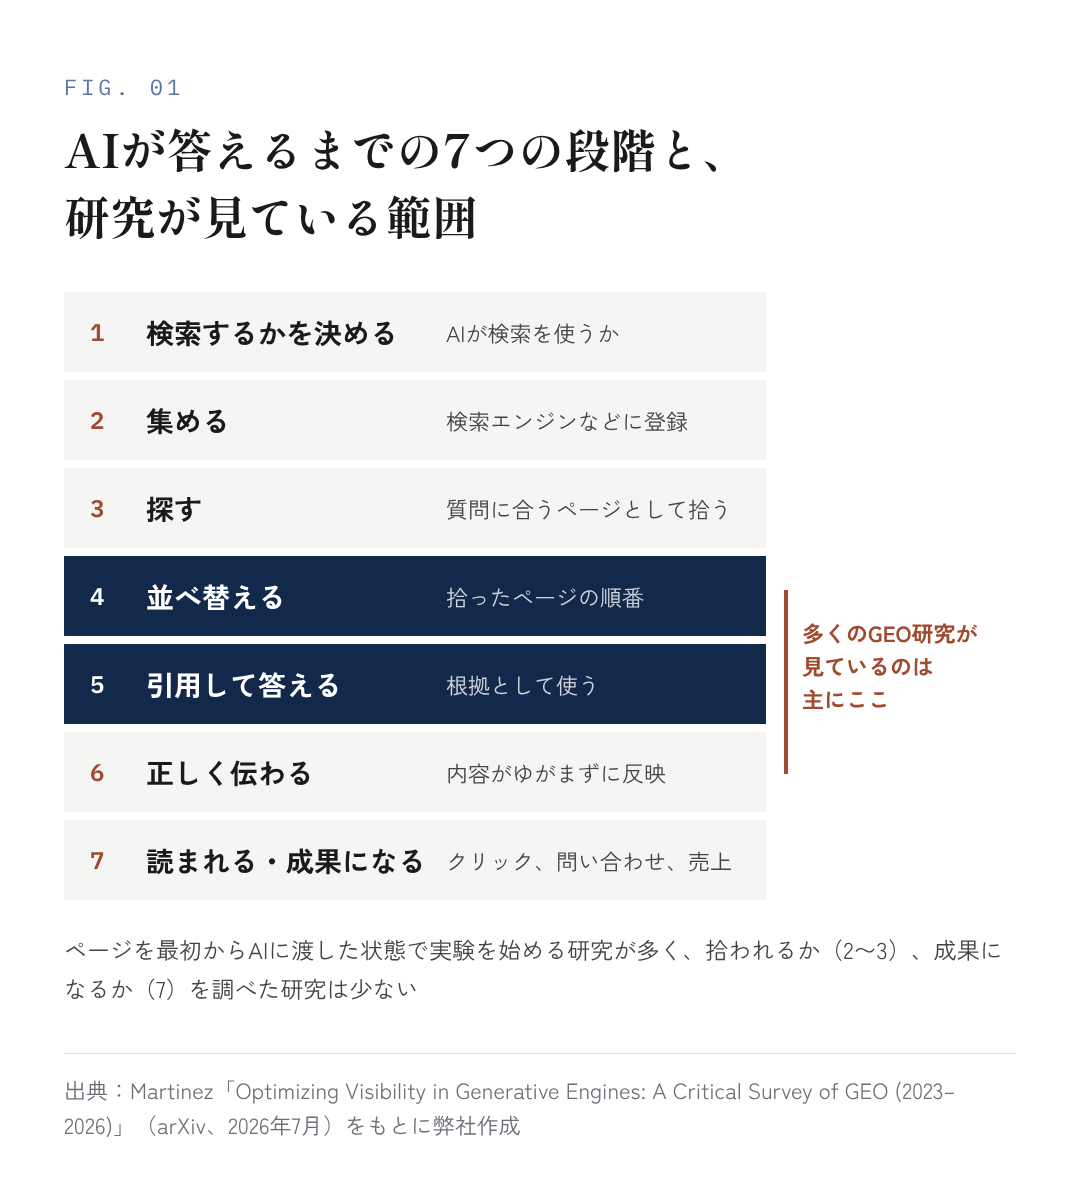
- 検索するかを決める:AIは、知っていることだけで答えて、検索しないこともあります
- 集める:ページが検索エンジンなどに登録されているか
- 探す:質問に合うページとして、検索で拾われるか
- 並べ替える:拾われたページの中で、何番目に読まれるか
- 引用して答える:答えの根拠として使われるか
- 正しく伝わる:書いてある内容が、ゆがまずに答えに反映されるか
- 読まれる、成果になる:クリックされ、問い合わせや売上につながるか
前の段階で落ちれば、その先には進めません。
ここで大事なのは、施策の効果を試すGEO研究の多くが、真ん中の4と5で効果を測っていることです。ページを最初からAIに渡した状態で実験を始めて、「どう書けば答えの中で多く使われるか」を調べている。そもそも検索で拾われるのか(2〜3)や、最後に問い合わせや売上につながるのか(7)を調べた研究は、まだ多くありません。企業が本当に知りたいのは、むしろそこなのに、です。
この記事の後半では、拾われる段階(3)と売上(7)を調べた数少ない研究に加えて、引用元の内容が正しく伝わるか(6)を調べた研究も紹介します。
この見方を持つと、AI検索対策の話を聞いたときに「それは、どの段階の話ですか」と問い返せるようになります。
「書き方の工夫で40%上がる」は、最初からAIに渡した5ページの中での話だった
GEOという言葉を広めたのは、2023年11月に公開された、米プリンストン大学などの研究者の論文です(Aggarwal氏ら、2023年)。この論文は、「引用文を足す」「統計を足す」といった書き方の工夫で、AIの答えの中での見え方が最大40%上がると報告しました。この「40%」は、海外では、いまも多くの解説記事で紹介されています。
サーベイは、この実験が何を測っていたのかを細かく確かめています。実験は、こういうものでした。
- ある質問で、Google検索の上位に出る5つのページを、最初からAIに渡しておく
- そのうちひとつのページだけ、書き方を変える
- AIの答えの中で、そのページの文章がどれだけ使われたかを測る
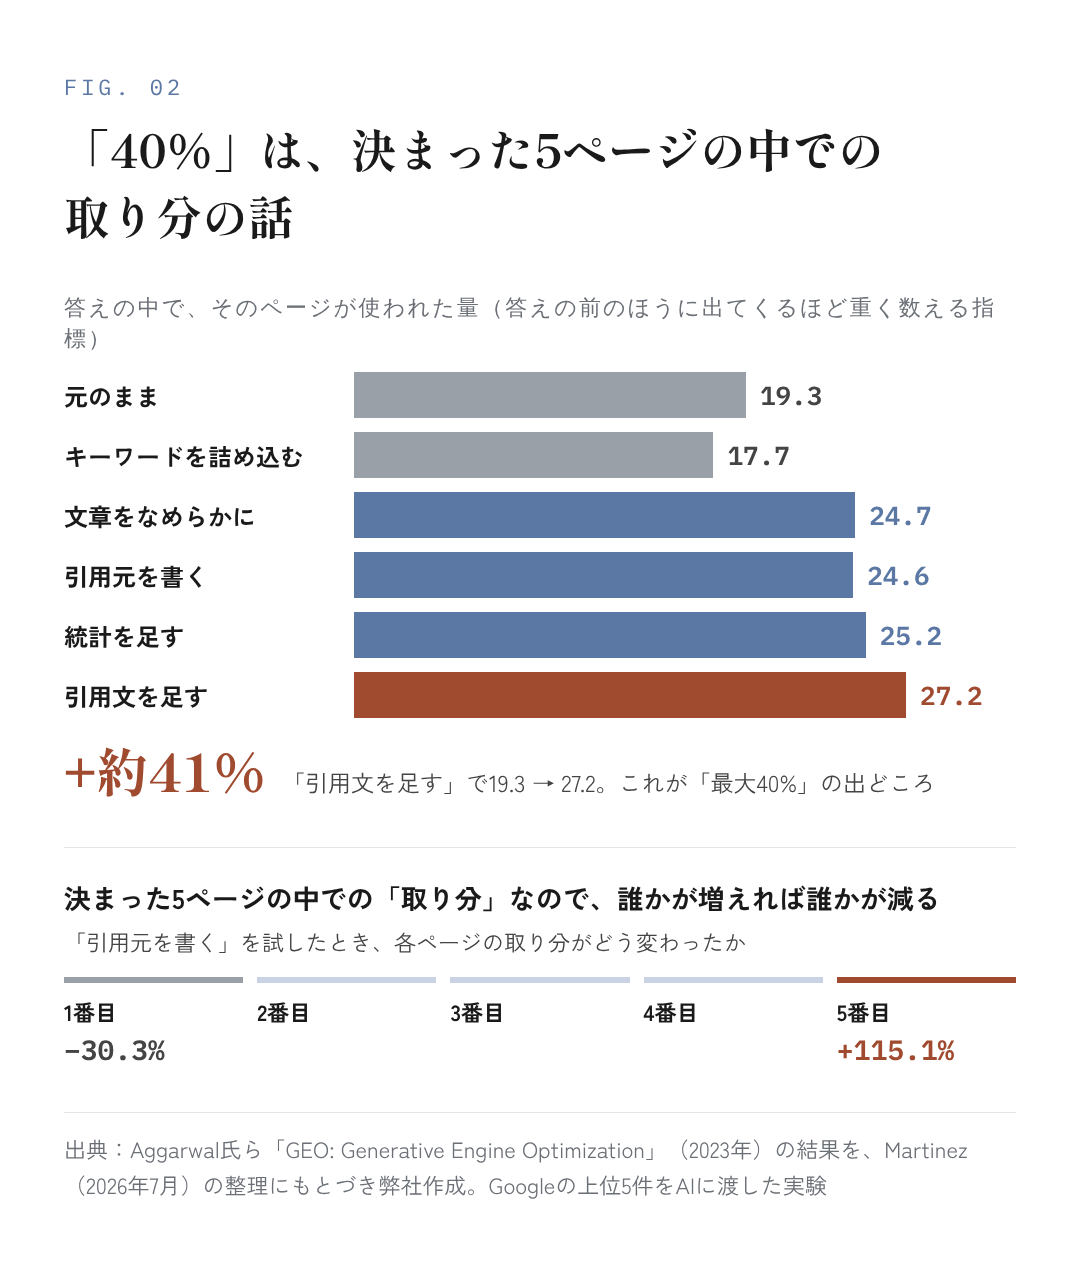
いちばん効果が大きかった「引用文を足す」では、使われた量の指標が19.3から27.2に上がりました。これが約41%の上昇で、「最大40%」の出どころです。
この数字が表しているのは、すでにAIに渡されている5ページの中で、そのページの取り分がどれだけ増えたかです。そもそも検索で拾われるかどうかや、クリックされるかどうかは、この実験では測っていません。
しかも取り分なので、誰かが増えれば、誰かが減ります。「引用元を書く」の工夫を試したときは、5番目のページの取り分が115.1%増えた一方で、1番目のページは30.3%減っていました。
こうした理由から、サーベイは「GEOで見え方が40%上がる」という言い方を、一般論としては成り立たないと結論づけています。元の論文の結果自体は正しく、確かめられたのは、AIに渡されているページは、書き方しだいで使われ方が変わるというところまでです。それが、自社のページがAIに見つけてもらえるようになることを意味するわけではありません。
効くと確かめられているのは、問いに合っていることと、AIが読むリストの上のほうにあること
では、何が効くとわかっているのか。サーベイは、研究ごとの結果を突き合わせて、施策ごとに根拠の強さを整理しています。ただし、ここでいう「効く」は、主に条件をそろえた実験の中での話です。実際のAI検索で長く効き続けるかまでは、まだわかっていません(この点は後で書きます)。
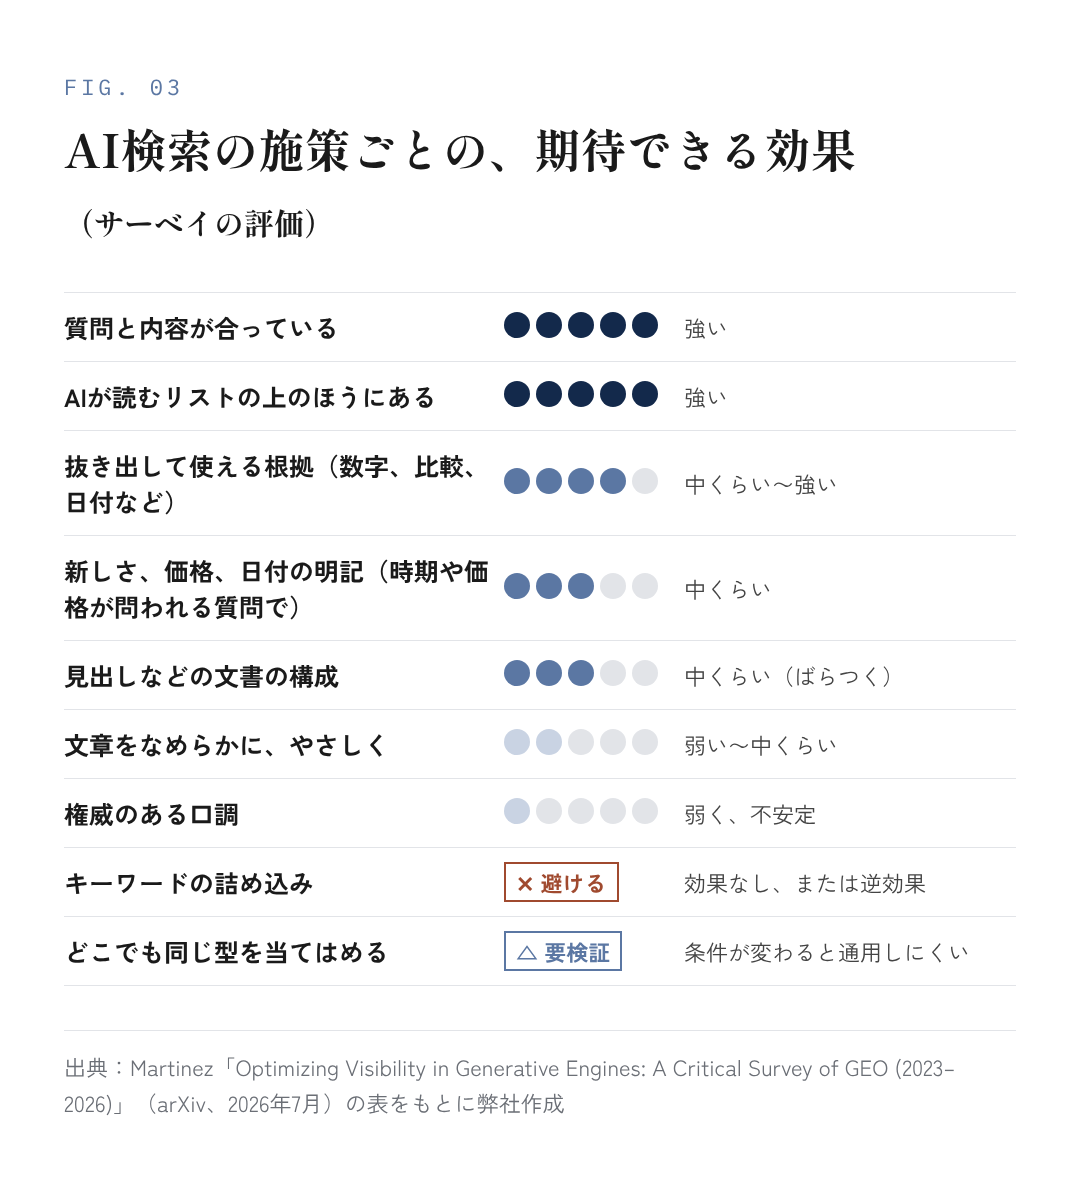
いちばん根拠が強いのは、次の2つです。
ひとつめは、質問と内容が合っていること。 言いかえると、その質問にはっきり答えているページかどうか、です。サーベイの評価でも、根拠の強さは「強い」とされています。ある研究では、AIは多くの場合、「この情報源は信頼できそうか」という手がかりよりも、「質問にはっきり答えているか」を優先していました(Wan氏ら、2024年)。この研究で比べられた信頼性の手がかりは、参考文献の有無や中立的な口調などです。それよりも、質問への答えのほうが優先されていました。
ふたつめは、AIが読むリストの上のほうにあること。 これは少しわかりにくいので、AIの動きから説明します。
検索して答えるAIは、一般的に、まず検索で集めたページを、順番のついたリストにして読み込みます。そのうえで、リストの中から使えそうな部分を選んで答えを書きます。研究でいう「位置」とは、このリストの中で何番目にあるかのことです。ページの上部に大事なことを書く、という意味ではありません。
研究では、このリストの上のほうにあるページほど、引用されやすいことがわかっています。6種類のAIで25万2,000回の試行を重ねた研究でも、最初に引用されるかどうかを主に決めていたのは、「質問との合い方」と「リストの中の位置」の2つでした(Vishwakarma氏ら、2026年、情報検索の国際学会SIGIR 2026に採択)。別の研究では、リストの中の順番を上げることのほうが、文章をあれこれ書き直すより効果が大きかったと報告されています(Puerto氏ら、2025年)。
実務に置き換えると、AIが答えを作るために行う検索で、上位に出てくることが大事、ということです。ここでいう検索は、お客さんが打った元の質問での検索とは限りません。AIは裏側で、質問を言いかえた検索をいくつも行っています。
その次に来るのが、数字や事実など、AIが抜き出して使える根拠が書いてあることです。サーベイは、統計、定義、比較、価格、日付、出典といった情報を挙げて、「AIが選び出して、出典つきで使える単位になる」ため有利になりやすい、と見ています。ただし、数字を足せばいいという話でもありません。質問に関係があり、確かめられて、いつの情報かがわかり、出どころが示されていることが大事だとしています。
反対に、「権威のありそうな口調で書く」は根拠が弱く、キーワードの詰め込みは効果がないか、逆効果でした。見た目の整え方だけを変えても、効果は弱かったそうです。そして、どんなページにも同じ型を当てはめるやり方は、条件が変わると通用しにくい、というのがサーベイの見立てです。
AIの答えに名前が挙がる会社の条件と、何から始めるかは、公開調査と弊社のデータをもとにホワイトペーパーにまとめています。
みんなが同じ工夫をすると、効果は薄れていく
見落とされがちな点がもうひとつあります。競合も同じことをしたら、どうなるのか。
約1,900の質問を使って、いくつもの分野で検証した研究があります。試した54通りの組み合わせのうち、はっきりプラスの効果が出たのは3通りだけでした。しかも、同じ工夫を取り入れるページが増えるほど、効果は小さくなっていきました(Puerto氏ら、2025年)。ネット通販の分野で、よく言われる15の工夫を試した研究でも、10個は効果がないか、マイナスでした(Bagga氏ら、2025年)。
考えてみれば、自然なことです。AIの答えに載せられる会社の数には限りがあります。AIが「おすすめ」として挙げる会社は、多くの場合、数社にとどまります。全員が「統計を足す」をやれば、統計があること自体は差になりません。
誰でもまねできるテクニックは、広まるほど効かなくなっていく可能性が高い。 実験の環境では、そうした結果が出ています。SEOで何度も見てきたことです。
引用を狙って書き直すと、かえって検索で拾われにくくなることがある
このサーベイで、私がいちばん考えさせられたのがここです。
17万件の文書と2,700の質問を使った研究で、「AIに引用されやすいように」本文だけを書き直す実験がありました。すると、そもそも検索で拾われる段階で、上位20件に入る割合が平均で約9%下がりました。拾われたページを並べ替えた後に上位10件に残る割合は16%、最終的に引用される割合も6%下がっています(Kim氏ら、2026年)。
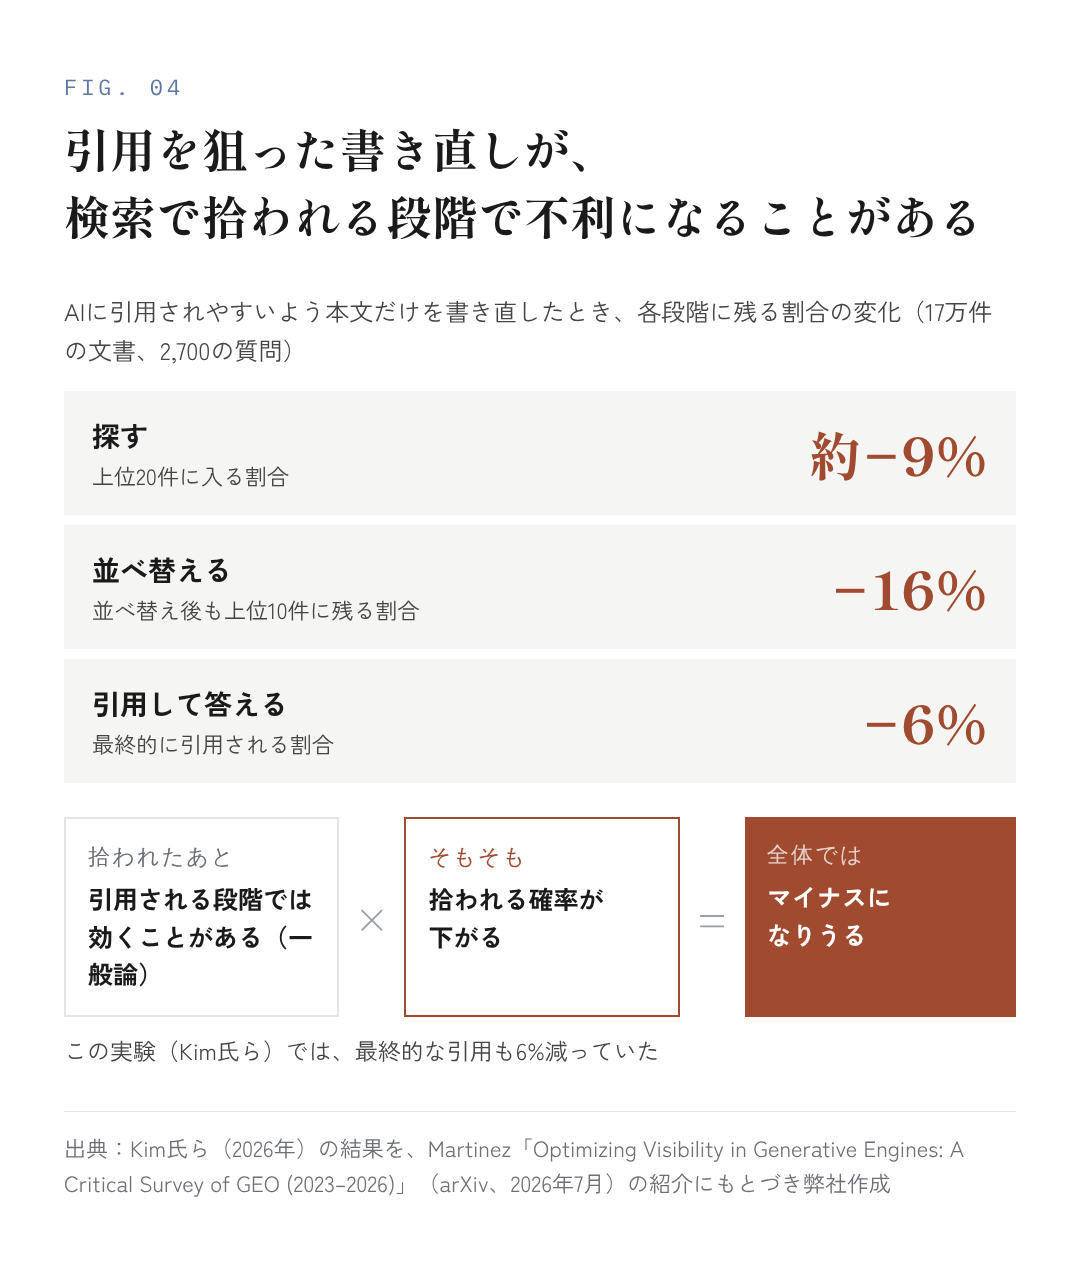
図1の段階で考えると、何が起きているかがわかります。
サーベイは、こうした書き直しが、AIに渡されたあとの5の「引用して答える」段階ではうまく働くことがあっても、その手前の3の「探す」段階で拾われにくくなり、競争で不利になることがあると指摘しています。引用される確率が少し上がっても、そもそも拾われる確率が下がれば、全体ではマイナスになりうる。 この実験では、最終的な引用も減っていました。
なぜ拾われにくくなるのか。ここからは私の推測ですが、AI向けに文章をいじった結果、本来の質問への答えとしてわかりにくくなるからではないかと考えています。
たとえば、「AIに抜き出されやすいように」と、どのページにも同じ型の要約や、統計の羅列を足していないでしょうか。人が読んで不自然な文章は、検索エンジンにとっても、問いへの答えとして読みにくくなっている可能性があります。
AIの答えは、聞くたびに、AIごとに変わる
実際のChatGPTやGoogleのAIを調べた研究からは、計測の難しさも見えてきます。
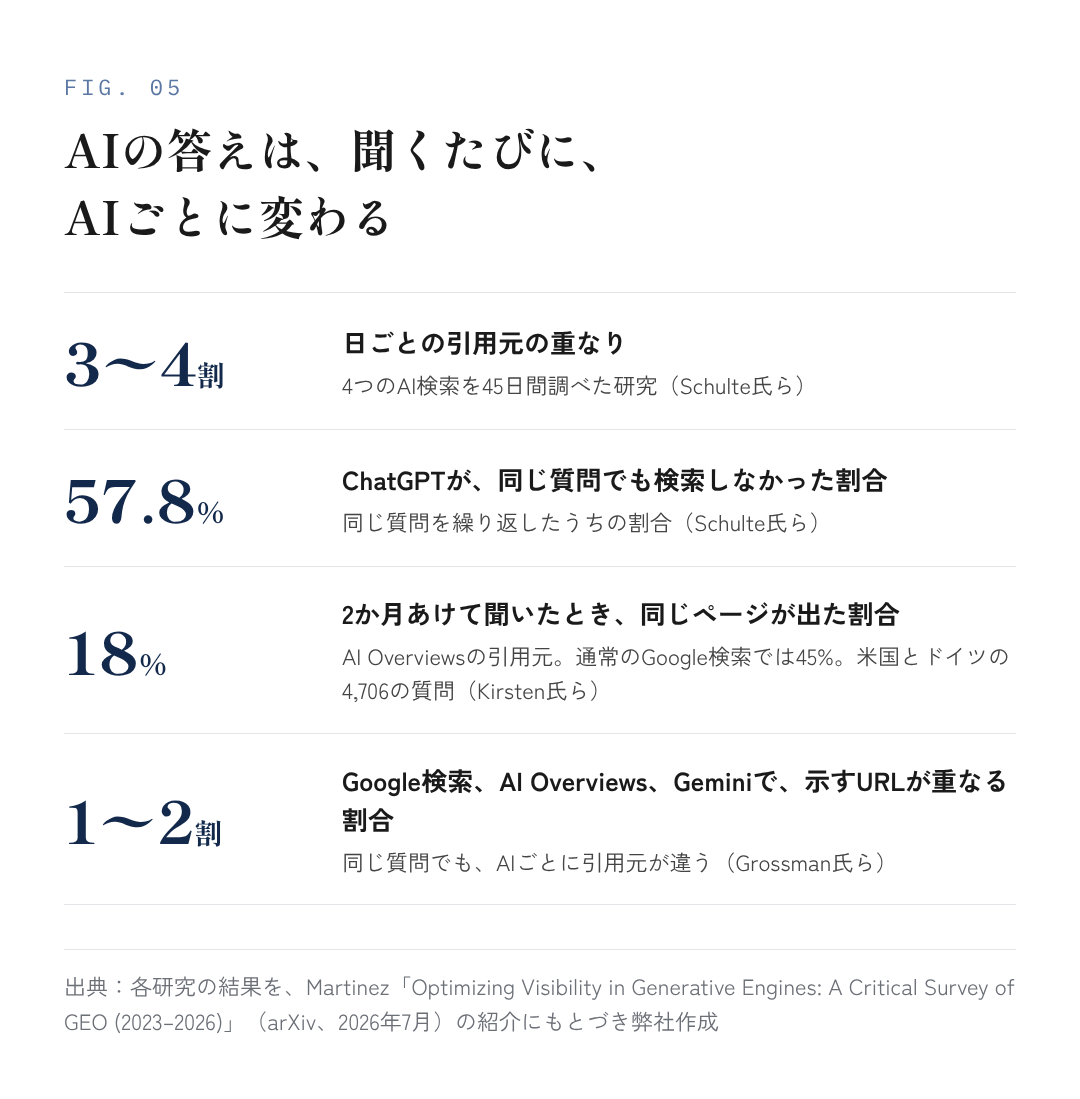
- 4つのAI検索を45日間調べた研究では、同じ質問に対して、日ごとの引用元の重なりは3〜4割程度でした。ChatGPTは、同じ質問を繰り返したうちの57.8%で、そもそも検索をしていませんでした(Schulte氏ら、2026年)
- 米国とドイツで4,706の質問を調べた研究では、2か月の間隔をあけて同じ質問をしたとき、同じページが出てきた割合は、通常のGoogle検索で45%、AI Overviews(Google検索の上に出るAIの要約)の引用元で18%でした。また、AI Overviewsに引用されたサイトの53%は、通常の検索結果の上位10件に入っていませんでした(Kirsten氏ら、2026年)
- 同じ質問でも、Googleの検索結果、AI Overviews、Geminiが示すURLは、1〜2割しか重なっていませんでした(Grossman氏ら、2026年、SIGIR 2026に採択)
ここからわかることは2つあります。
ひとつは、AIに1回聞いて「載っていた」「載っていなかった」で判断しても、ほとんど意味がないということ。明日聞けば違う答えが返ってくるかもしれないし、別のAIならまったく違う引用元になるかもしれません。
もうひとつは、Googleでの順位を見ているだけでは、AIに引用されているかはわからないということです。AI Overviewsに引用されたサイトの半分以上は、通常の検索結果の上位10件の外から来ていました。理由のひとつとして、AIが元の質問とは別の検索もして、ページを集めていることが考えられます(この仕組みは、クエリ・ファンアウトの記事で詳しく書きました)。
AIに「知られている」ことと、「勧められる」ことは別の話
もうひとつ印象に残ったのは、スタートアップ112社を調べた研究です(Sharma氏、2026年。査読前の、ひとつの研究です)。
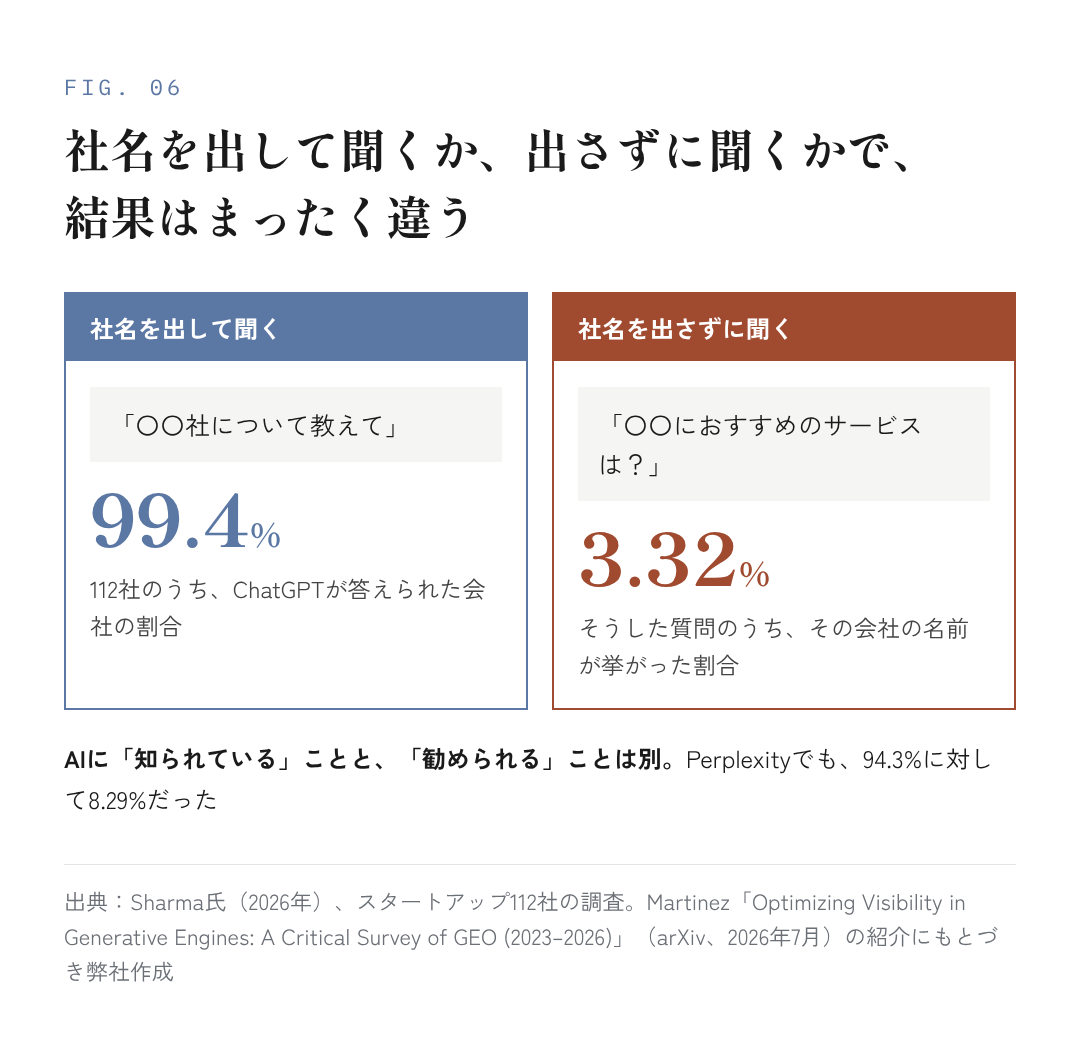
社名を出して「〇〇社について教えて」と聞くと、ChatGPTは99.4%の会社について答えられました。ところが、社名を出さずに「〇〇におすすめのサービスは?」と聞くと、そうした質問のうち、その会社の名前が挙がったのは3.32%だけでした。AI検索サービスのPerplexityでも、94.3%に対して8.29%です。
AIは、その会社のことを「知っている」。でも、お客さんが探しているときに「勧めてくれる」とは限らない。この2つは、まったく別の話です。
自社名でAIに聞いて、きちんと説明してくれたから安心、とはいえません。お客さんは、まだ自社の名前を知らない状態で「おすすめは?」と聞いてきます。マーケティングで大事なのは、そのときに名前が挙がるかどうかのほうです。
AIは、引用元の内容を正しく伝えているとは限らない
図1の6つめの段階、「正しく伝わる」についての研究もあります。
- 2023年当時のBing Chatなど4つのAI検索の答えを調べた研究では、答えの文のうち、引用元で完全に裏づけられていたのは51.5%でした。付けられた引用のうち、その主張を実際に支えていたのは74.5%です(Liu氏ら、2023年)
- 流行中の話題についての55,393の質問を40日間調べた研究では、答えに含まれる98,020の主張のうち、約11%が、自動判定で引用元による裏づけが不十分とされました(Xu氏ら、2026年)
AIに引用されていても、自社のページに書いてあることが、そのとおりに伝わっているとは限りません。古い料金のまま紹介されていたり、別の会社の説明と混ざっていたりすることもありえます。引用されたかどうかに加えて、どう伝わっているかまで確かめる必要があります。
AIに引用されると売上が増えるのかは、まだ確かめられていない
そして、企業にとっていちばん大事な問いです。AIに引用されると、問い合わせや売上は増えるのか。
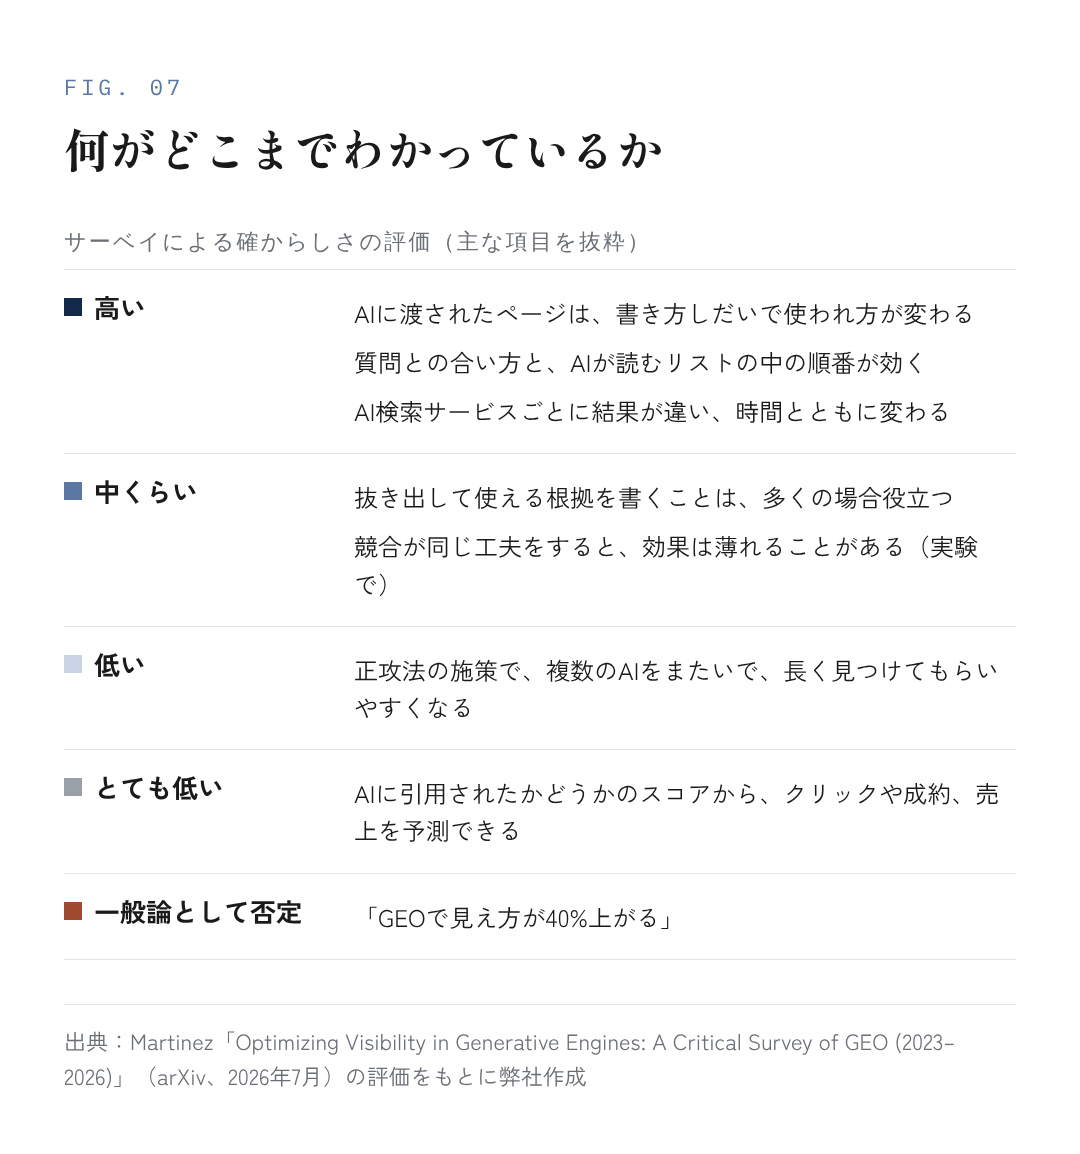
サーベイの評価では、「AIに引用されたかどうかのスコアから、クリックや成約、売上を予測できる」という主張の確からしさは「とても低い」です。
数少ない手がかりとして、ChatGPT経由の流入を調べた研究があります。あるサイトで、ChatGPT経由の流入は全体で5.7倍に増えました。ただ、対策をしていないページだけでも3.5倍に増えていました。ChatGPTを使う人そのものが増えていたからです。その増加分を差し引いて推計すると、対策による上乗せは約1.8倍でした(Watanabe氏・Nakayashiki氏、2026年)。それでもサーベイは、効果を示唆する段階にとどまり、因果関係までは確かめられていないと評価しています。
もうひとつ、「ガイドラインに沿った正攻法の施策で、複数のAIをまたいで、長く見つけてもらいやすくなる」ことの確からしさも「低い」とされています。確かめようとした研究はごくわずかで、安定して長く効くことを示した研究はありませんでした。むしろ、先ほどの書き直しの実験のように、逆効果の結果も出ています。
わかっているのは、まだ誰も、きちんと測れていないということです。AI検索対策に意味がないと決まったわけでもありません。だからこそ、自社のAIでの見え方と、問い合わせや売上の数字を、並べて見ていくことに価値があります。
読み解き:サーベイが勧めるのは「問いに答える、確かめられる、拾われるページ」と「分けて測ること」
ここからは、私の読み解きです。
サーベイ自身も、実務への提言をまとめています。それは、とても控えめなものでした。「質問に関係があり、網羅的で、確かめられて、構成がはっきりしていて、技術的に拾われるページをつくること。そのうえで、拾われたか、引用されたか、正しく伝わったかを、分けて測ること」。
特別なテクニックは、ひとつも入っていません。でも私は、これを読んで悲観するより、やるべきことがはっきりしたと感じました。
根拠がもっとも強かった2つのうち、自社のコンテンツで直接手を入れられるのは「質問と内容が合っていること」です。これは、お客さんが聞きそうな質問を想定して、その質問にはっきり答えるコンテンツをつくっていく、ということに尽きます。ほかの4つは、そのコンテンツをAIに見つけてもらい、正しく使ってもらい、効果を確かめるための話です。BtoB企業の実務に落とすと、こうなると考えています。
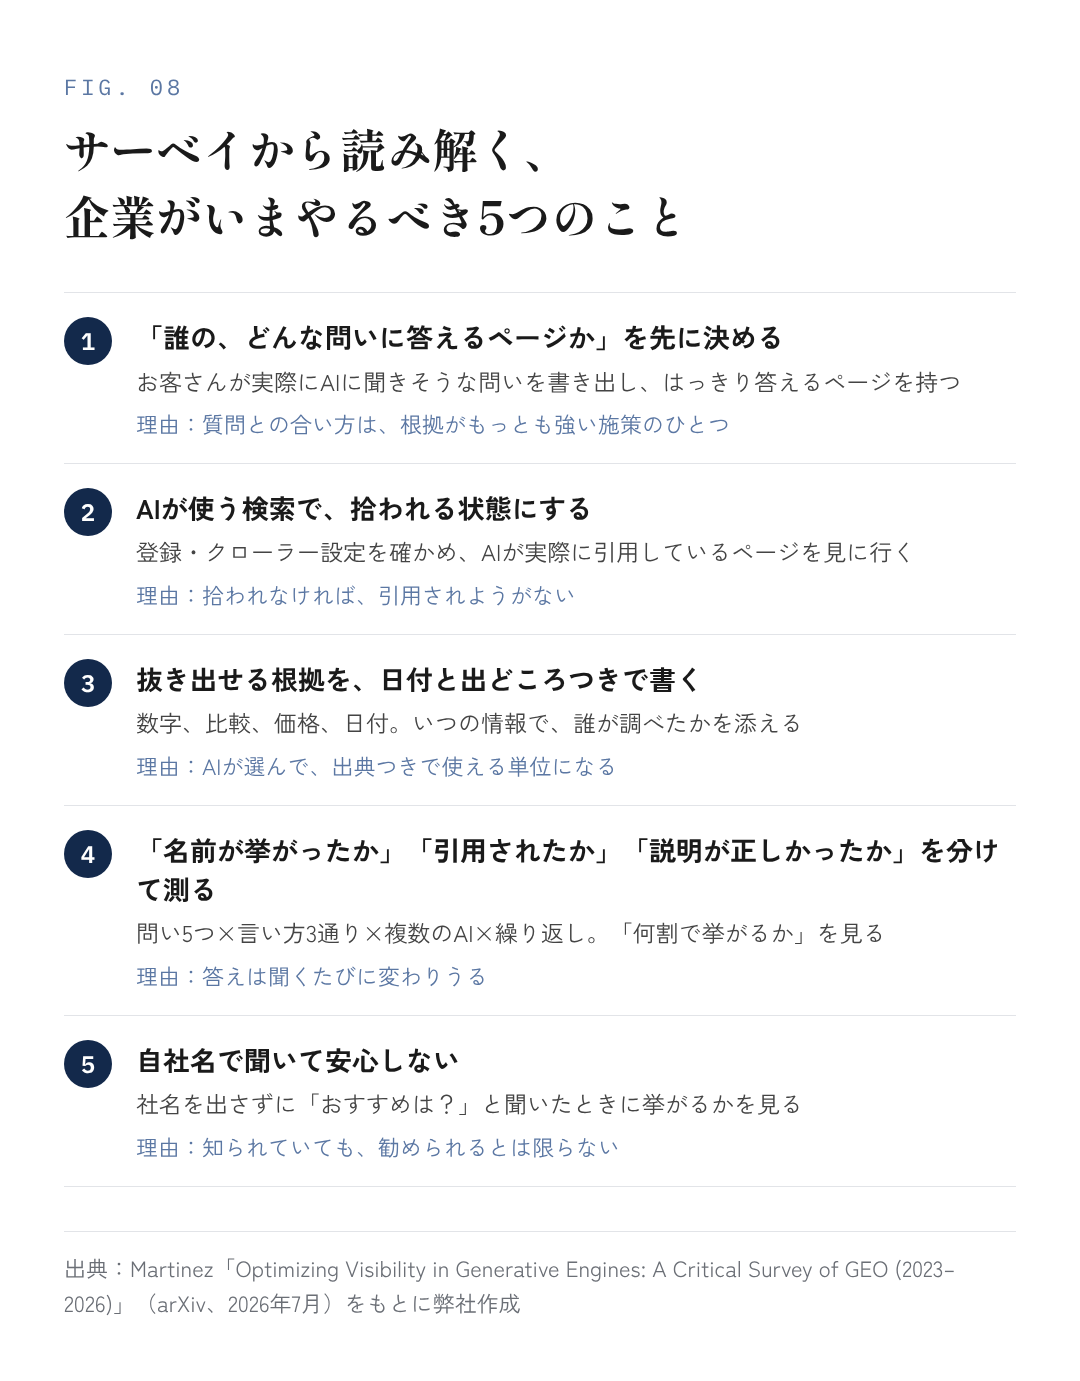
1. 「誰の、どんな問いに答えるページか」を先に決める
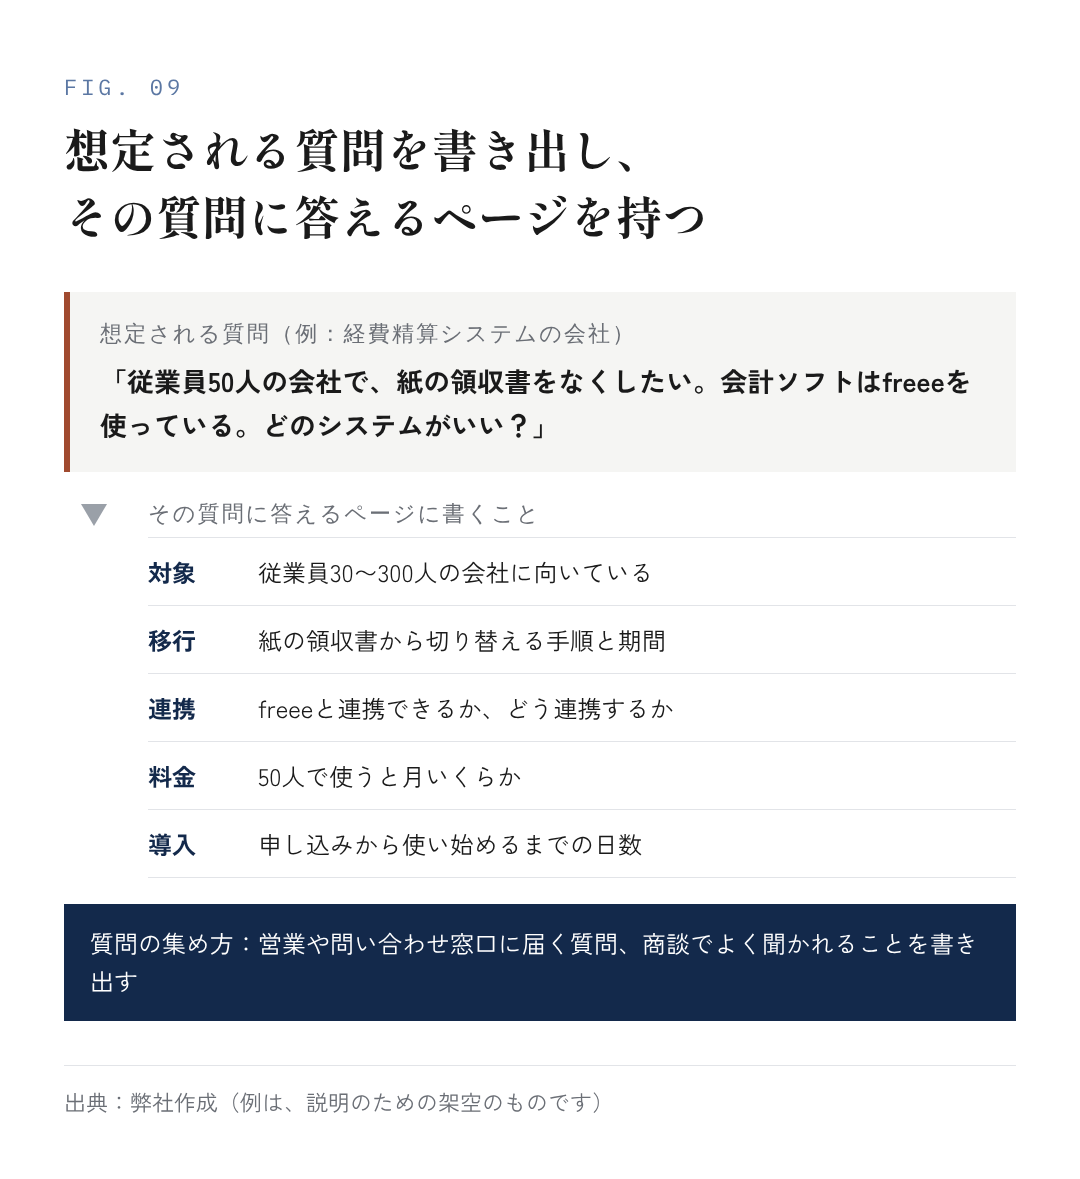
根拠がもっとも強い2つのうちのひとつが、質問と内容が合っていることでした。AIへの質問は、検索キーワードよりずっと具体的です。
たとえば、経費精算システムを売っている会社なら、お客さんがAIに聞くのは「経費精算システム おすすめ」より、「従業員50人の会社で、紙の領収書をなくしたい。会計ソフトはfreeeを使っている。どのシステムがいい?」のような問いです。
この問いに答えるページには、対象の会社規模、紙の領収書からの移行の手順、freeeとの連携の可否、料金、導入までの期間が書いてある必要があります。製品の総合ページに一行書いてあるだけでは、この問いの答えとしては弱い。お客さんが実際に聞きそうな問いを書き出して、その問いにはっきり答えるコンテンツを、ひとつずつ持つ。これが、いちばん効果が見込めるやり方です。営業や問い合わせの窓口に届く質問、商談でよく聞かれることは、そのまま問いのリストになります。
2. AIが使う検索で、拾われる状態にする
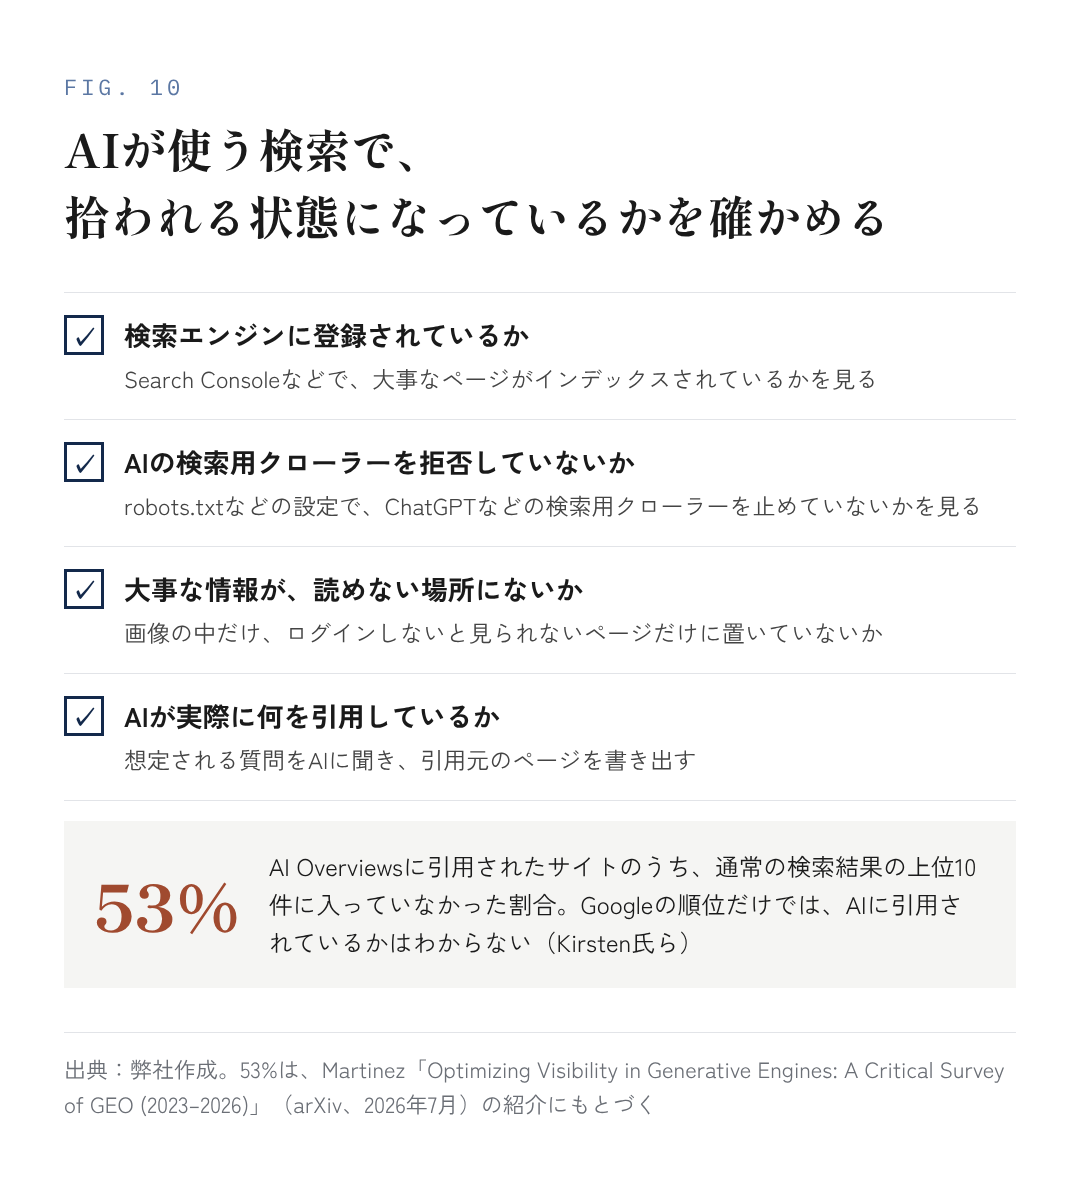
AIに引用されるには、その手前で、AIが行う検索に拾われる必要があります。そして、拾われたページのリストの上のほうにいるほど、引用されやすい。
具体的には、次のことを確かめます。
- 自社サイトが検索エンジンにきちんと登録されているか
- ChatGPTなどのAIの検索用クローラーを、設定で拒否していないか
- 大事な情報が、画像の中や、ログインしないと見られない場所だけに置かれていないか
- 1で書き出した問いをAIに聞いたとき、AIがどんなページを引用しているか
最後の点が大事です。先ほど見たとおり、AI Overviewsに引用されたサイトの半分以上は、通常の検索結果の上位10件の外から来ていました。Googleの順位表だけ見て安心せず、AIが実際に何を読んでいるかを見に行く。 引用されているのが比較サイトや業界メディアなら、そこに自社の正しい情報が載っているかを確かめることも、拾われるための対策になります。
3. AIが抜き出して使える根拠を、日付と出どころつきで書く
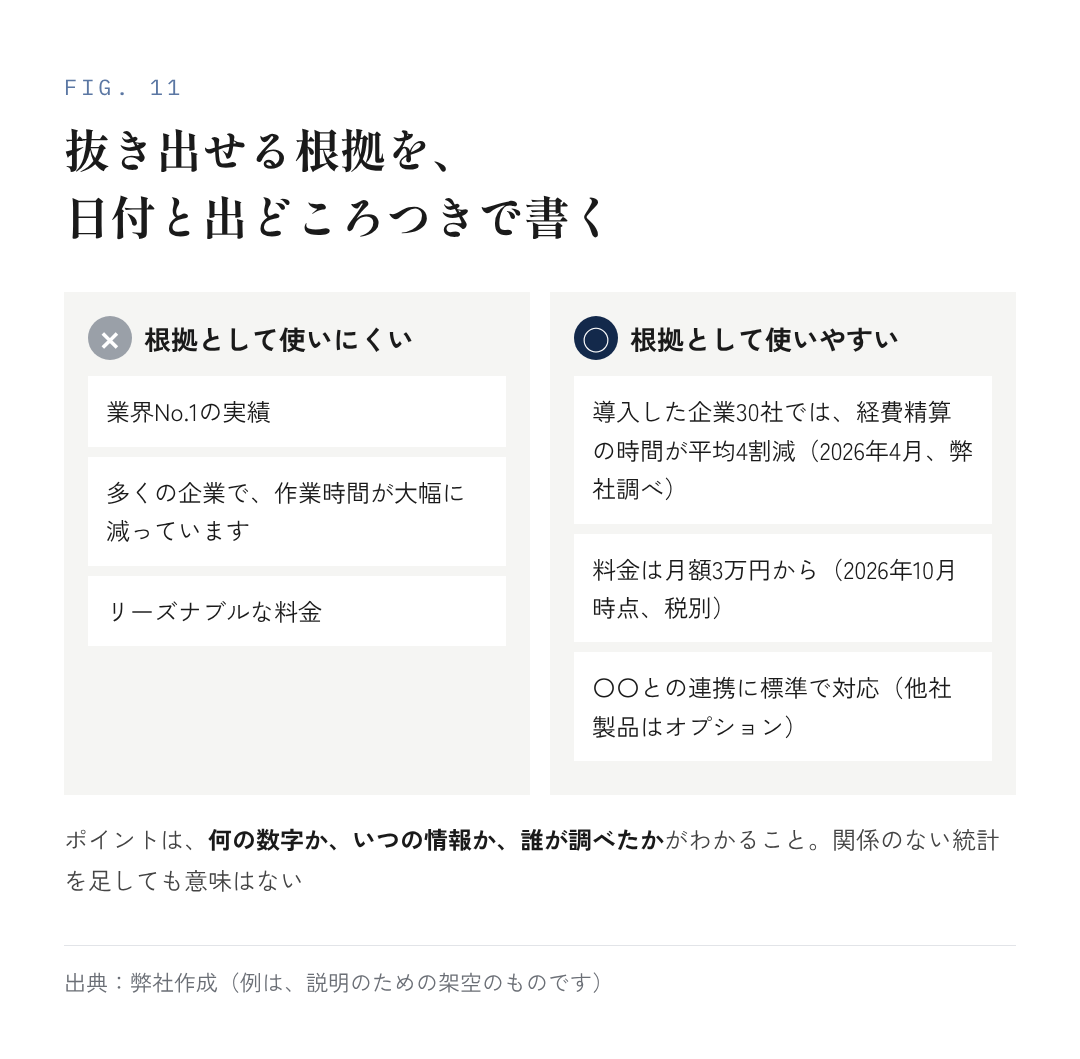
数字や比較、価格、日付は、AIが選び出して、出典つきで使える単位になりやすいと、サーベイは見ています。ただし、関係のない統計を足しても意味はありません。
たとえば、こうした書き方です。
- 「導入した企業30社では、経費精算にかかる時間が平均で4割減りました(2026年4月、弊社調べ)」
- 「料金は、月額3万円から(2026年10月時点、税別)」
- 「他社製品との違い:〇〇の連携に、標準で対応」
ポイントは、何の数字か、いつの情報か、誰が調べたかがわかることです。日付も出どころもない「業界No.1」のような表現は、AIにとっても、根拠として使いにくい情報です。(上の数字は、書き方の例です)
4. 「名前が挙がったか」「自社のページが引用されたか」「説明が正しかったか」を分けて、繰り返し測る
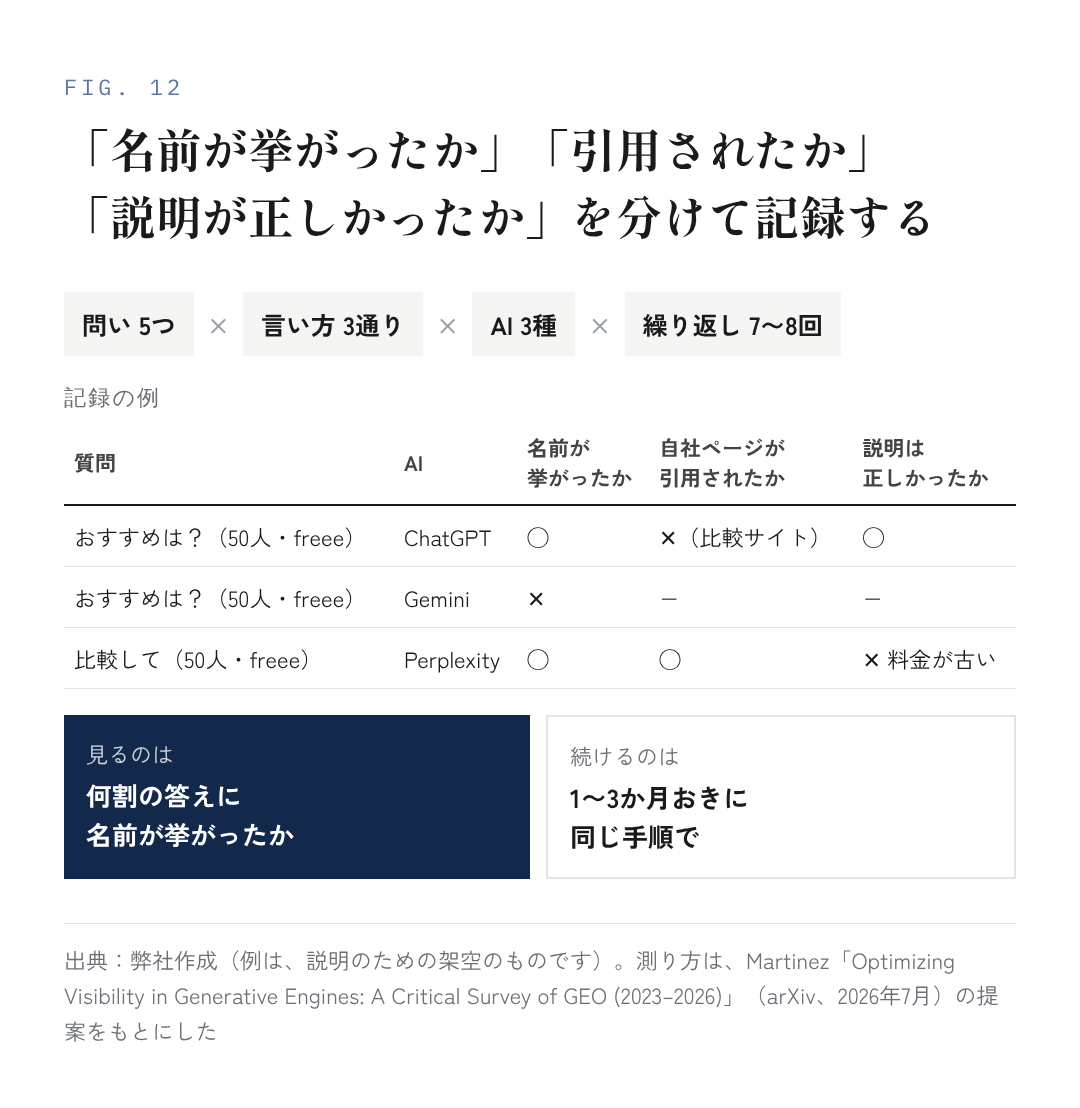
サーベイは、「拾われたか」「引用されたか」「正しく伝わったか」を分けて測ることを勧めています。AIの中で何が起きたかは外から見えないので、企業が手元で確かめられる形に置きかえると、たとえばこうなります。
- 1で書き出した問いから、大事なものを5つ選ぶ
- それぞれ、言い方を変えた質問を3通り用意する(サーベイは3〜5通りを勧めています。例:「おすすめは?」「比較して」「〇〇に向いているのは?」)
- ChatGPT、Gemini、Perplexityなど、複数のAIで、同じ質問を何度か繰り返して聞く(ある研究〔Schulte氏ら〕は、まず7〜8回から始めることを提案しています)
- 毎回、「自社の名前が挙がったか」「自社のページが引用されたか」「自社の説明は正しかったか」を、分けて記録する。AIが検索しなかった、引用元を出さなかった、という結果も、捨てずに記録する
- これを、1〜3か月おきに続ける
見るべきは、「何位だったか」より「何割の答えに名前が挙がったか」と、その変化です。1回の答えに一喜一憂する必要はありません。「挙がったけれど、説明が間違っていた」という結果も、立派な発見です。
測り方の考え方と、診断で確かめられることは、AI検索診断のご案内にまとめています。
5. 自社名で聞いて安心しない
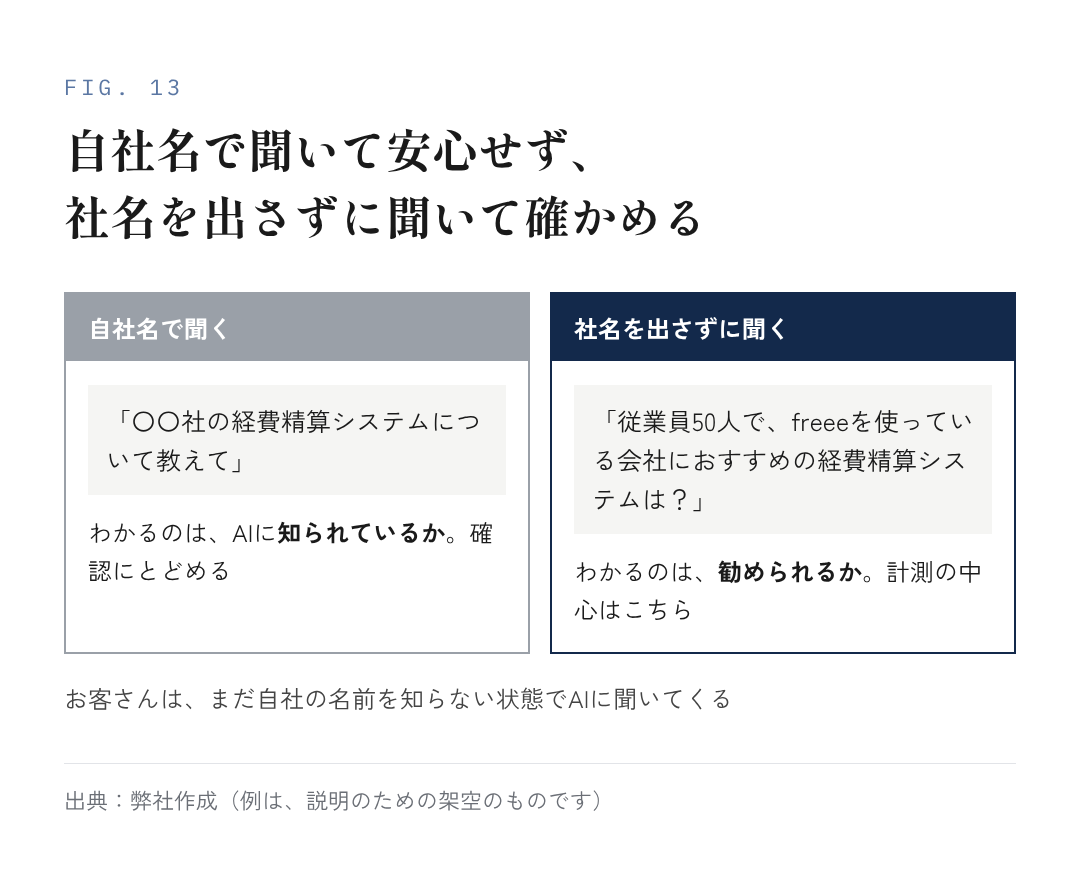
自社名で聞いたときの答えは、あくまで「知られているか」の確認です。お客さんの立場で、社名を出さずに「おすすめは?」と聞いたときに挙がるかどうか。4の計測の中心は、こちらに置きます。
並べてみると、AIO対策の記事でお伝えしたこととも、同じ方向を向いています。研究をたどっても、特別なテクニックは見つかっていません。 見えてくるのは、お客さんの問いに、確かめられる根拠を添えて、はっきり答えること。昔から変わらない「いい答えを書く」ことでした。
このサーベイの限界:効果の大きさは統合しておらず、査読前の研究も多い
最後に、このサーベイ自体の限界も書いておきます。著者も論文の中で、次の点を認めています。
- 決まった手順で網羅的に研究を集めて、効果を数字で統合する「システマティック・レビュー」とは違い、研究の広がりを見渡して全体像を整理する「スコーピング・レビュー」です。研究ごとの効果の大きさを、ひとつの数字にまとめることはしていません
- 主要な研究のいくつかは査読前で、企業が資金を出したものもあります
- 同じ「ChatGPT」でも、開発者向けのAPIで使うか、一般向けの画面で使うかなどで、条件が違います。研究ごとの数字を、そのまま比べることはできません
それでも、45本の研究を同じ基準で並べて、「どこまでがわかっていて、どこからがわかっていないか」を示した価値は大きいと思います。AI検索対策の話を聞いたときに、「それは、どの段階の、どんな条件での話ですか」と問い返せる。社内で議論するときの基準として、手元に置いておきたい論文です。
参考:Martinez「Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026)」(arXiv、2026年7月)/Aggarwal et al.「GEO: Generative Engine Optimization」(2023年)。本文中のVishwakarma氏ら、Wan氏ら、Puerto氏ら、Bagga氏ら、Kim氏ら、Schulte氏ら、Kirsten氏ら、Grossman氏ら、Sharma氏、Watanabe氏・Nakayashiki氏の研究は、いずれもMartinez氏のサーベイでの紹介にもとづいています
 WRITTEN BY佐藤 大貴アースダイバー株式会社 代表取締役DeNAで男性向けライフスタイルメディアの立ち上げを牽引し、ローンチから約1年半で月間3,000万PV規模に。ポートではコンテンツマーケティング責任者として幅広い領域のメディアを管掌し、上場とM&Aを経験。2019年に創業し、AI時代のマーケティング戦略とその実行を手がける。プロフィールを見る →LinkedIn