- 同じ質問をAPIと実際の画面で聞くと、挙がるブランドの重なりは1割前後という調査がある
- 地域・検索の有無・モデル・利用者の記憶など、APIでは合わせきれない部分がある。日本語で測るときは特に注意が要る
- 正確に知るには、お客様が使う画面で、条件をそろえて何度も測り、割合で見ること
こんにちは、アースダイバー代表の佐藤です。AIの答えの中で自社がどう扱われているかを測る「LLMOツール」が、国内外で増えています。ツールを導入した会社からは、「ツールの数字と、自分でAIに聞いた結果が合わない」という声も聞こえてきます。
この記事では、LLMOツールの数字がどこまで正しいのかを、2026年に海外で発表された研究と調査をもとに整理します。あわせて、弊社がなぜ、実際のAIの画面で測ることにこだわっているのかもお話しします。
先に、この記事の結論を3行で書きます。
- APIで取った答えは、お客様が見ている画面の答えと大きく違う:同じ質問をAPIと実際の画面で聞くと、挙がったブランドの重なりは1割前後という調査がある
- 調整しても、同じにはならない:地域・検索の有無・モデル・利用者の記憶など、APIでは合わせきれない部分がある。日本語で測るときは特に注意が要る
- 正確に知るには、実際の画面で、条件をそろえて、何度も測る:1回の順位で判断しないで、割合で見る
目次
LLMOツールは、AIの答えをどう取っているか
LLMOツールは、決めておいた質問をAIに聞き、答えの中に自社の名前が出たか、何番目か、どのサイトが出典に使われたかを記録します。答えの取り方は、大きく2つあります。
| 取り方 | しくみ | 特徴 |
|---|---|---|
| API | AIの会社が開発者向けに出している接続の仕組み(API)を使い、プログラムで質問を送る | 大量に、安く、同じ条件で聞ける。ただし、利用者が使う画面とは別の仕組み |
| 画面から取る | chatgpt.comなど、利用者が使う画面で質問し、表示された答えを記録する | お客様が見ている答えに近い。ただし、手間と費用がかかる |
APIは便利です。ただ、APIで返ってくる答えが、お客様がChatGPTやGeminiの画面で見ている答えと同じとは限りません。OpenAIのAPIの説明書にも、APIの検索の結果とChatGPTの画面との関係については、記載がありません(OpenAI)。
APIと実際の画面は、どのくらい違うのか
2026年には、この違いを実際に比べた研究や調査が、いくつも出ています。
挙がるブランドの重なりは、1割前後
AI検索の分析ツールを提供するBrandlightは、2026年6月に、2026年のサッカーW杯に関する900の質問を、APIと実際の画面の両方でChatGPT・Gemini・Perplexityに聞き、2,565組の答えを比べました。APIでも検索を使う設定にし、APIと画面の答えは1日ずらして集めています。なお、同社は画面から測るツールを提供している会社です(Brandlight)。
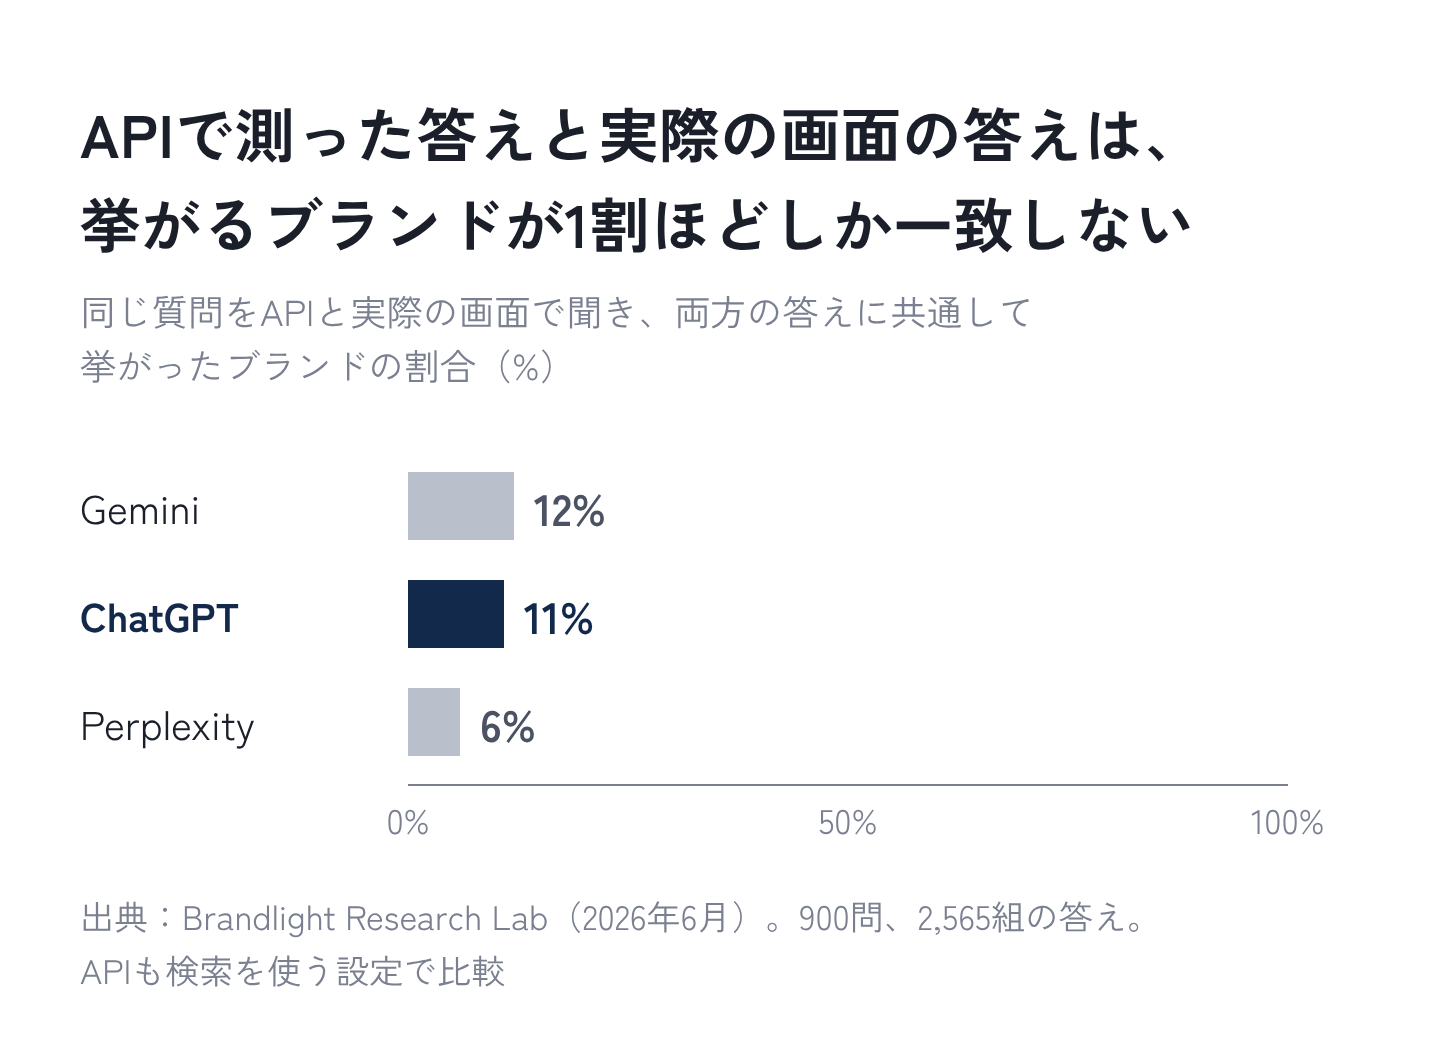
挙がったブランドの重なりは、ChatGPTで11%、Geminiで12%、Perplexityで6%でした。答えの中で1番目に挙がったブランドが同じだったのも、9〜16%にとどまっています。同社は「APIの上に組み立てたAIの可視性の数字は、すべて代わりの指標にすぎない」と結論づけています。
研究でも、APIで再現できた引用は約4分の1
2026年10月には、研究者のグループが、ChatGPTの画面で実際に引用されたページを、Google検索とOpenAIのAPIでどこまで再現できるかを調べた論文を発表しました。両方を組み合わせても、再現できた引用は「約4分の1」でした。サイトの単位で見れば一致は高くなるものの、ページの単位では大きくずれていました(arXiv)。
AIが答える前に調べる言葉も、ひとつも一致しなかった
AIは、答える前に、質問を言い換えた検索を裏で何本も行います(クエリ・ファンアウトとは)。この裏の検索を比べた調査もあります。Genezioは、英国の銀行の分野で、27日間に3,645の会話をAPIとchatgpt.comで比べました(Genezio)。
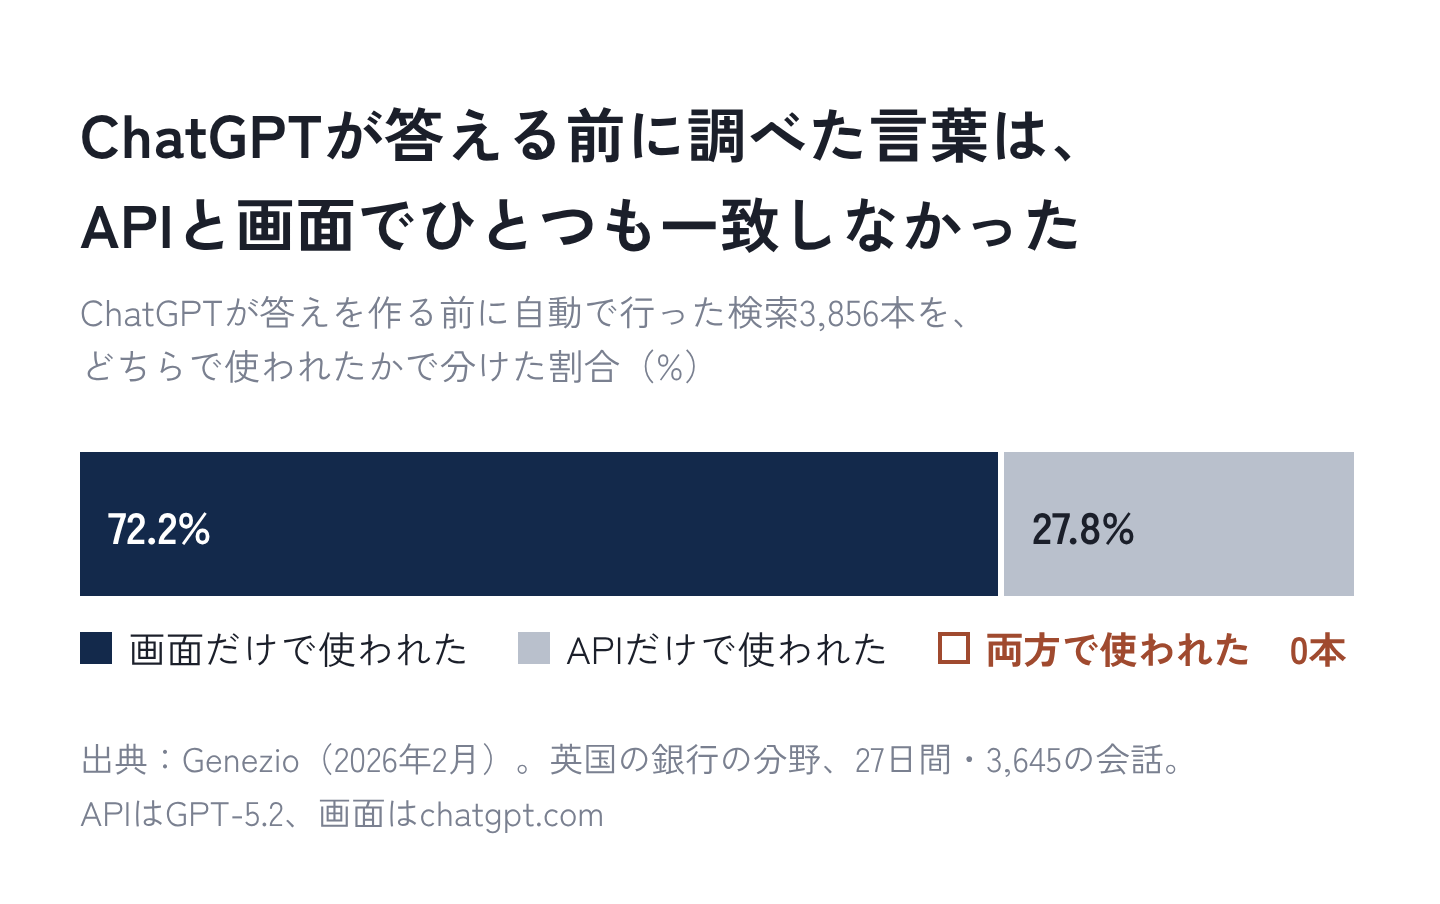
ChatGPTが答える前に自動で行った検索3,856本のうち、APIと画面の両方で使われた検索の言葉は、0本でした。出典に使われたURLも、重なったのは12.3%です。さらに、銀行のサイトが出典に占める割合は、APIでは36.0%、画面では6.1%と、大きく違っていました。この調査では、APIで測ると、銀行のサイトが実際より多く引用されているように見えました。
「APIを独自に調整している」で、どこまで近づけるか
ツールの中には、APIを使いながら「独自に調整して、画面に近づけている」と説明しているものもあります。APIで設定できることは、確かにあります。OpenAIのAPIでは、利用者のおおよその地域(国・都市など)、検索で読む量、検索するサイトの絞り込み、使うモデルなどを指定できます(OpenAI)。
ただし、調整で合わせきれない部分も多く残ります。
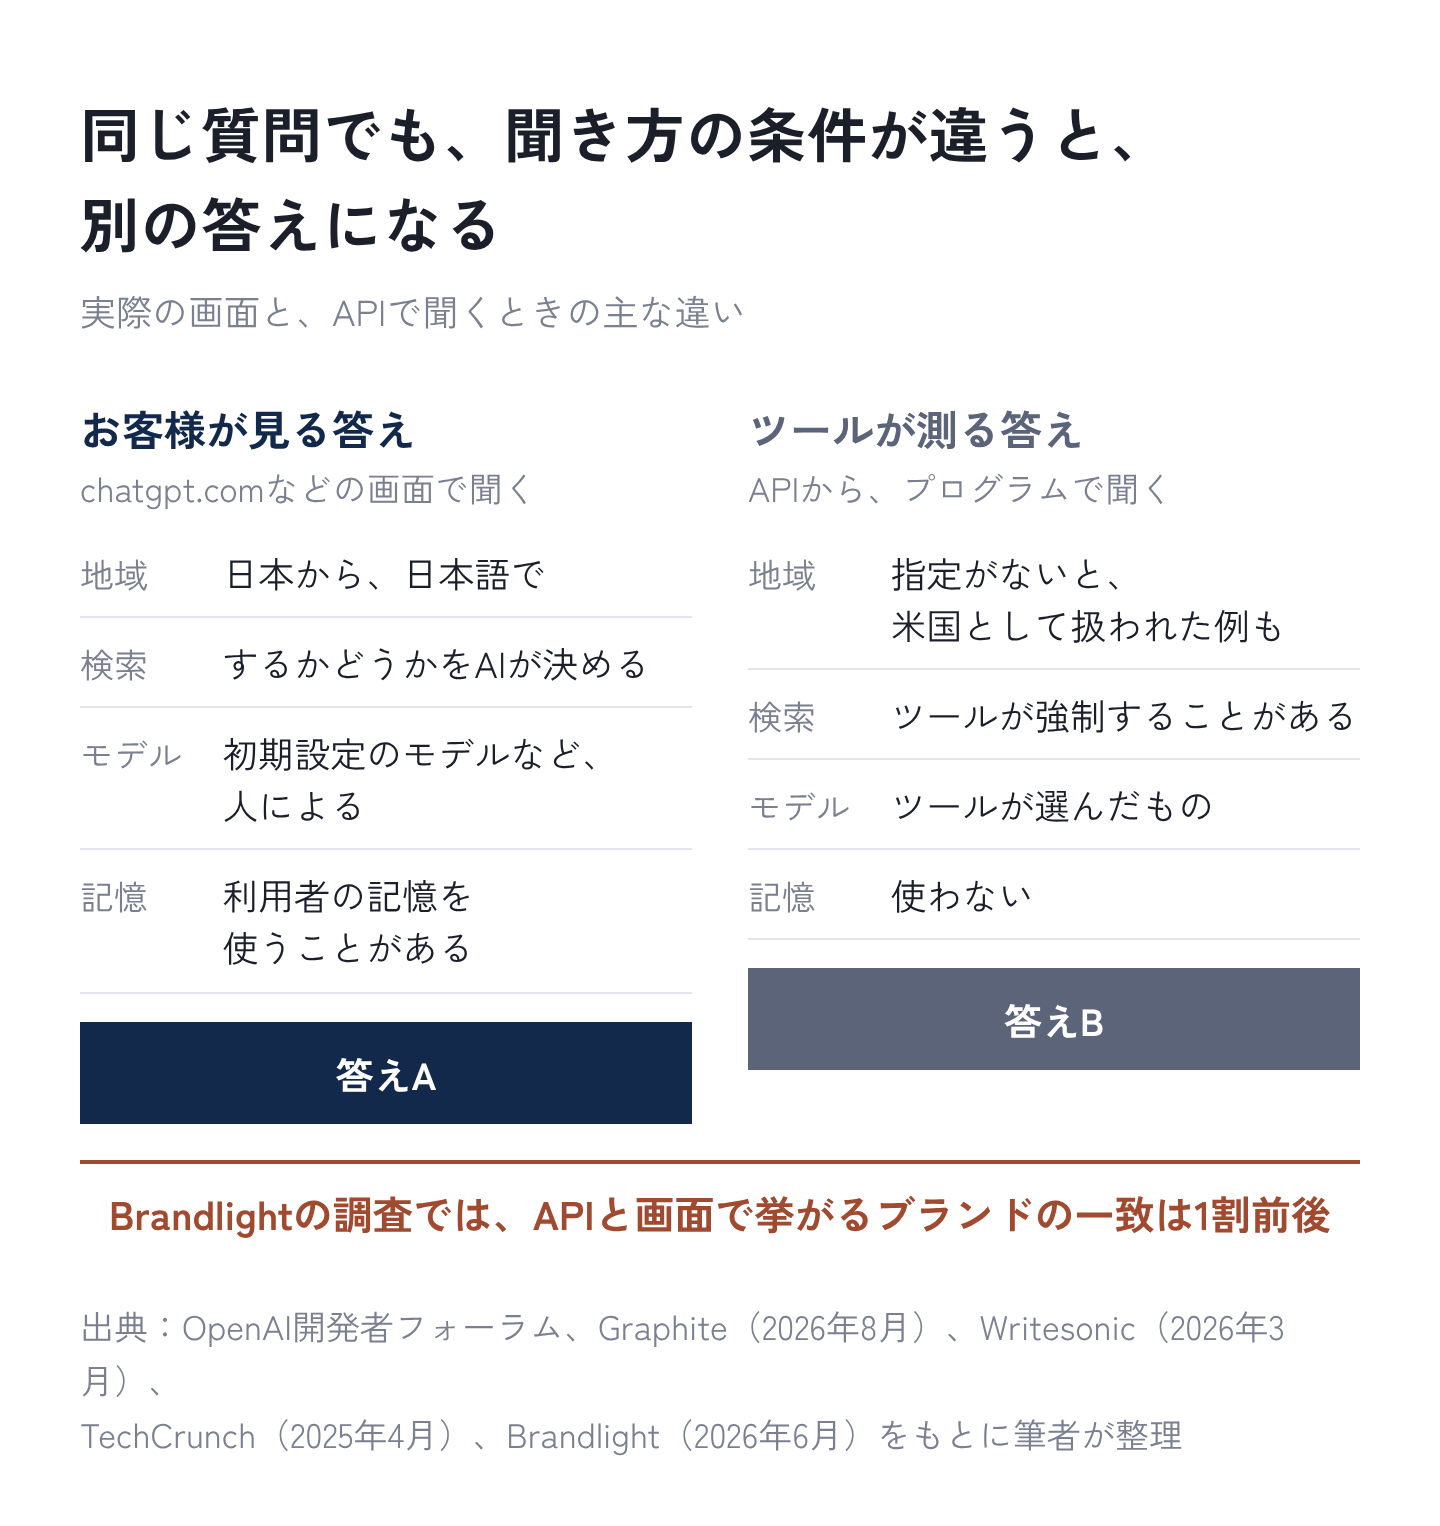
図3の4つの違いには、それぞれ根拠があります。
- 地域:OpenAIのAPIで検索を使うと、地域を指定しない場合に、AIが利用者を米国にいるものとして扱ったという報告があります。フォーラムの回答でも、地域をはっきり設定するよう勧められています(OpenAIの開発者フォーラム)
- 検索するかどうか:ツールが検索を強制すると、自然には検索しない質問で、挙がる割合が平均で約20ポイントずれたという調査があります(Graphite)
- モデル:ChatGPTの初期設定のモデル(GPT-5.3 Instant)と上位のモデル(GPT-5.4 Thinking)で50問を比べると、引用の重なりは平均7%だったという調査があります(Writesonic)。利用者がどのモデルで聞いているかを、APIでそろえるのは難しくなります
- 利用者ごとの記憶:ChatGPTは、記憶の機能が有効な場合、利用者の記憶をもとに検索の言葉を書き換えることがあります(TechCrunch)
先に紹介したBrandlightの調査も、APIで検索を使う設定にしたうえでの結果です。それでも、重なりは1割前後でした。
弊社の見方:調整によって、画面に近づけることはできると考えています。ただ、同じにはなりません。「独自に調整している」というツールを選ぶときは、何をどう調整しているのか、そして調整したあとの数字が実際の画面とどのくらい一致するのかを、データで示してもらうことをおすすめします。それが示されないなら、数字は方向を見るための参考にとどめるのが安全です。
日本語で測るときに、特に気をつけたいこと
海外の議論は英語での比較が中心ですが、日本の会社にとっては、言語と地域の違いがより大きな問題になります。
- AIは、英語以外の質問でも、英語で検索している:Peec AIが1,000万件を超える質問を分析したところ、英語以外の質問でも、ChatGPTが裏で行った検索の43%は英語で行われていました。日本語だけの数字は示されていません(Peec AI)
- 答えのばらつきは、言語で大きく変わる:2026年7月の論文では、8つの言語で集めた1万2,933件の答えで、ブランドへの評価(好意的か否定的か)のばらつきを分析したところ、26.5%が質問の言語で説明できました。ブランドそのものの違いで説明できたのは1.5%です(arXiv)
- GeminiのAPIの検索には、地域を指定する項目が見当たらない:GoogleのGemini APIの検索の説明には、地域を指定する項目が見当たりません(Google AI for Developers)
日本語の質問で、APIと画面の結果を比べた公開の研究は、いまのところ見当たりません。ただ、地域を指定しないAPIで日本語の質問を聞くと、米国の利用者として扱われた答えを測っているおそれがあります。
同じ質問でも、答えは毎回変わる
APIか画面かに関係なく、AIの答えは聞くたびに変わります。SparkToroの調査では、同じ推薦の質問を何度も聞いて、同じ顔ぶれのブランドが返ってきたのは1%未満、同じ順番まで一致したのは0.1%未満でした(Search Engine Journal)。先の論文でも、1回の答えで、ブランドごとの評価の違いを見分ける信頼性は、ほぼ0(0.01)でした(arXiv)。
1回聞いて「何位だった」と判断するのは危険です。答えは、何度も聞いて「何割で挙がるか」という割合で見る必要があります。
正確さを上げるには
ここまでの研究と、弊社の経験から、AIの答えをできるだけ正確に測る方法をまとめます。
- お客様が使う画面で測る。APIは、条件を変えて試すときの補助として使う
- 国と言語を、お客様に合わせる。日本のお客様なら、日本から、日本語で聞く
- 検索を強制しない。AIが自分で検索するかどうかも、測る対象に含める
- 前の質問の影響を消す。ログインしない状態で、1問ごとに新しい画面を開く
- 1回で判断しない。同じ質問を複数のAIで聞き、言い回しを変えた質問も混ぜて、割合で見る
- 名前が挙がったかと、出典に使われたかを分けて数える
- 実際の数字と照らし合わせる。GA4でのAIからの訪問や、社名での検索の数とあわせて見る
ツールを選ぶ前に、確かめたい5つの質問
LLMOツールを使うこと自体は、悪いことではありません。大量の質問を、長い期間追うには、ツールが向いています。選ぶ前に、次の5つを確かめてください。
| 確かめること | 理由 |
|---|---|
| APIで取っているか、画面から取っているか | APIと画面では、挙がるブランドが大きく違うという調査がある |
| どの国から、何語で聞いているか | 地域を指定しないAPIは、米国の利用者として扱われたという報告がある |
| 1問を何回聞いているか | 1回の結果は、ほとんど当てにならない |
| 検索を強制していないか | 強制すると、挙がる割合が大きくずれることがある |
| 誤差の幅を示しているか | 割合の上下が、たまたまか、本当の変化かを見分けるため |
弊社が、実際の画面で測る理由
弊社のAI検索診断は、ChatGPT・Gemini・GoogleのAIモードの実際の画面に、質問を入力して測っています。APIや自動取得のツールは使いません。ログインしない状態で、1問ごとに新しい画面を開き、同じ日のうちに3つのAIをすべて測ります。日本から日本語で、ログインしない状態で聞いたときの答えを、条件をそろえて記録するためです。
画面で測っても、条件がずれることはあります。弊社が診断したある会社では、AIの答えの中に「前回の課題を踏まえると」という、前の質問の流れを引き継いだ表現が見つかりました。弊社では、こうした回答を集計から外し、条件をそろえて測り直しています。数字だけを自動で集めていると、こうしたずれに気づきにくくなります。
そしてもうひとつ、弊社がいちばん大切にしているのは、答えを人が読むことです。名前が出た回数を数えるだけなら、ツールでもできます。弊社は、90回答すべてを読み、AIが自社をどう説明しているか、その説明が事実と合っているか、どの競合がどんな理由で推薦されているか、AIがどのサイトを読んでいるかまで確かめます。そのうえで、どこで・何を・どのぐらい直すかの指針をお出しします。診断の進め方は、LLMO診断とは?でくわしく説明しています。
一方で、手作業で測れる数には限りがあります。そのため、弊社では、1回の診断で、30問を3つのAIに1回ずつ聞いた90回答をまとめて、AIごと・テーマごとの割合で傾向を見ます。施策の効果は、同じ質問で3か月後・6か月後に測り直して確かめます。変化を細かく追いたい場合は、ご希望に応じて、毎週・毎月の定点の計測も組み合わせます。
LLMOツールについて、よくある質問
LLMOツールは、使わないほうがいいですか?
使い方しだいです。大量の質問を、長い期間、同じ条件で追うには、ツールが向いています。ただ、ツールの数字を、お客様が実際に見ている答えそのものとして扱うのは危険です。方向を見るための目安として使い、重要な判断の前には、実際の画面で確かめることをおすすめします。
APIで測ったツールの数字は、意味がないのですか?
意味がないとは考えていません。同じ条件で測り続ければ、増えたか減ったかの方向はある程度わかります。ただし、その数字が、お客様が画面で見ている答えとどのくらい一致するかは、ツールごとに確かめる必要があります。
手作業で、十分な数を測れますか?
1回の診断では、30問を3つのAIに聞いた90回答をまとめて見ています。1問ずつの「出た・出ない」で判断しないで、AIごと・テーマごとの割合で傾向を見るためです。変化を細かく追いたい場合は、毎週・毎月の定点の計測と組み合わせます。
参考:Brandlight Research Lab(2026年6月)/Jiang ほか「Understanding ChatGPT Citations」(arXiv、2026年10月)/Genezio(2026年2月)/OpenAI「Web search」/OpenAI開発者フォーラム(2026年4月)/Graphite(2026年8月)/Peec AI(2026年2月)/Żatuchin(arXiv、2026年7月)/Writesonic(2026年3月)/TechCrunch(2025年4月)/Google AI for Developers「Grounding with Google Search」/Search Engine Journal(SparkToroの調査、2026年1月)
 WRITTEN BY佐藤 大貴アースダイバー株式会社 代表取締役DeNAで男性向けライフスタイルメディアの立ち上げを牽引し、ローンチから約1年半で月間3,000万PV規模に。ポートではコンテンツマーケティング責任者として幅広い領域のメディアを管掌し、上場とM&Aを経験。2019年に創業し、AI時代のマーケティング戦略とその実行を手がける。プロフィールを見る →LinkedIn