AI検索サービスAI検索対策(LLMO対策・AIO対策)は、AIの答えの中の自社を測ることから
お客様・候補者・患者は、ChatGPTやGemini、GoogleのAIによる概要やAIモードに聞いて、候補を決めはじめています。アースダイバーのAI検索診断(LLMO診断)は、その人たちが実際にAIに聞く質問で、自社や医師が挙がるか、どう説明されているかを測ります。これまで50社以上で行ってきた診断を、目的に合わせてご用意しています。おすすめのAI検索対策サービスを比べている方にも、施策を決める前に、まずこの診断で現状を確かめることをおすすめしています。
LLMO対策・AIO対策は、まず測ることから
AI検索対策は、AIの答えの中で、自社が候補に挙がり、正しく説明されるようにする取り組みです。呼び方はいくつかありますが、目指すことは同じです。AIの答えは、聞く人や聞き方、AIの種類で変わるため、何を直すかを決める前に、いまの扱われ方を測ることが欠かせません。
- 1測るAIの答えの中で、自社がどの質問で挙がり、どの質問で挙がらないか、説明が正しいかを確かめます。AI検索診断で行います
- 2直すAIが読んでいるページと情報をもとに、自社サイトのページや外部サイトの情報を、AIが根拠にできる形に整えます
- 3測り直す同じ質問で測り直して、答えが変わったかを確かめ、次に直すところを決めます
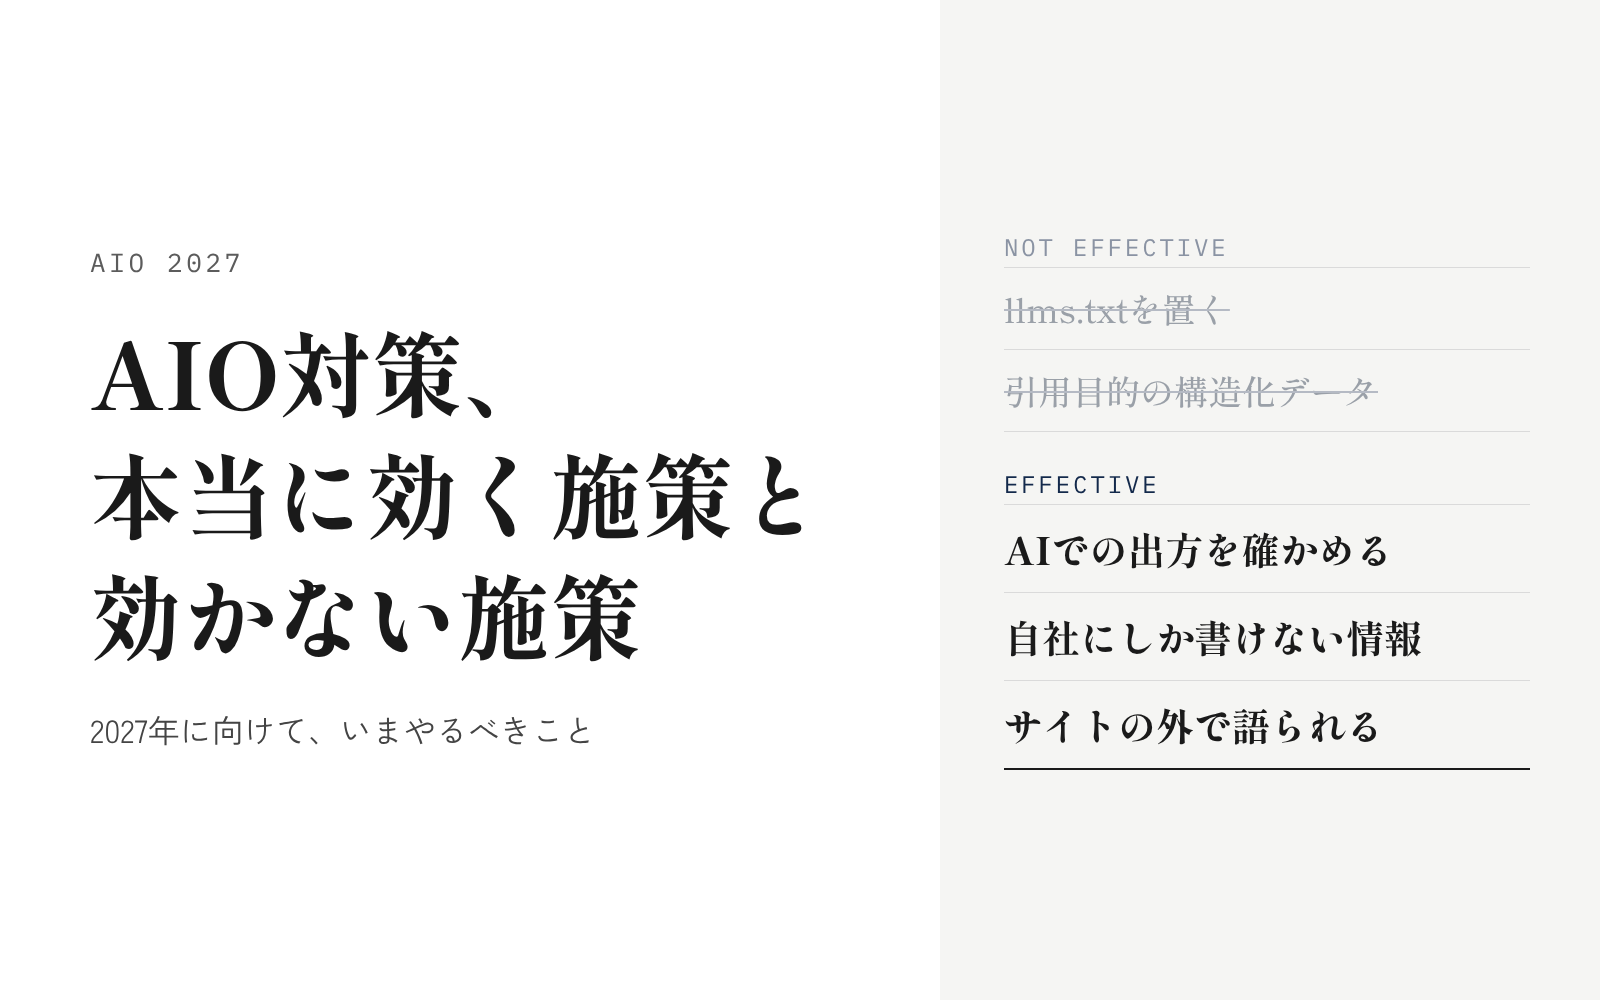
AI検索対策で効く施策と効かない施策は、AIO対策(LLMO対策)とは?でくわしく解説しています。
目的に合わせて選べる診断
AIの答えを、相手が実際に見る形で測る診断です
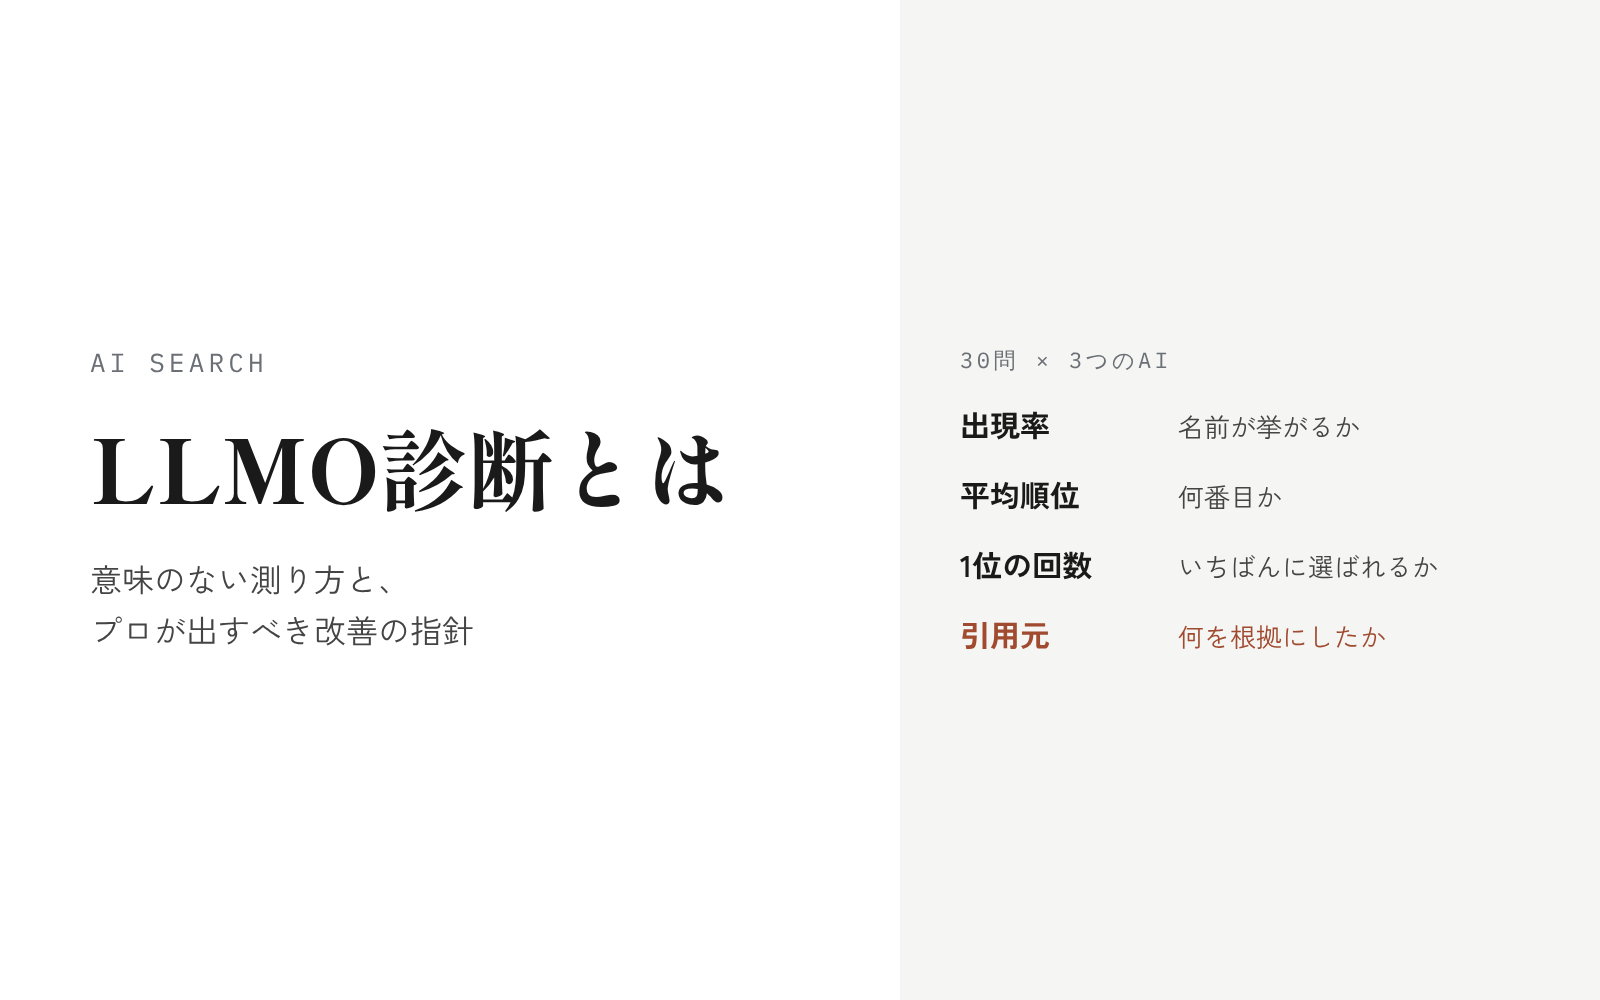
AIは、聞く人・聞き方・AIの種類で答えを変えます。AI検索診断は、お客様・候補者・患者が実際にAIに聞く質問を設計し、実際の画面で測ります。そのうえで、AIの答えを人が読み、何を直せば答えが変わるかまでお出しします。
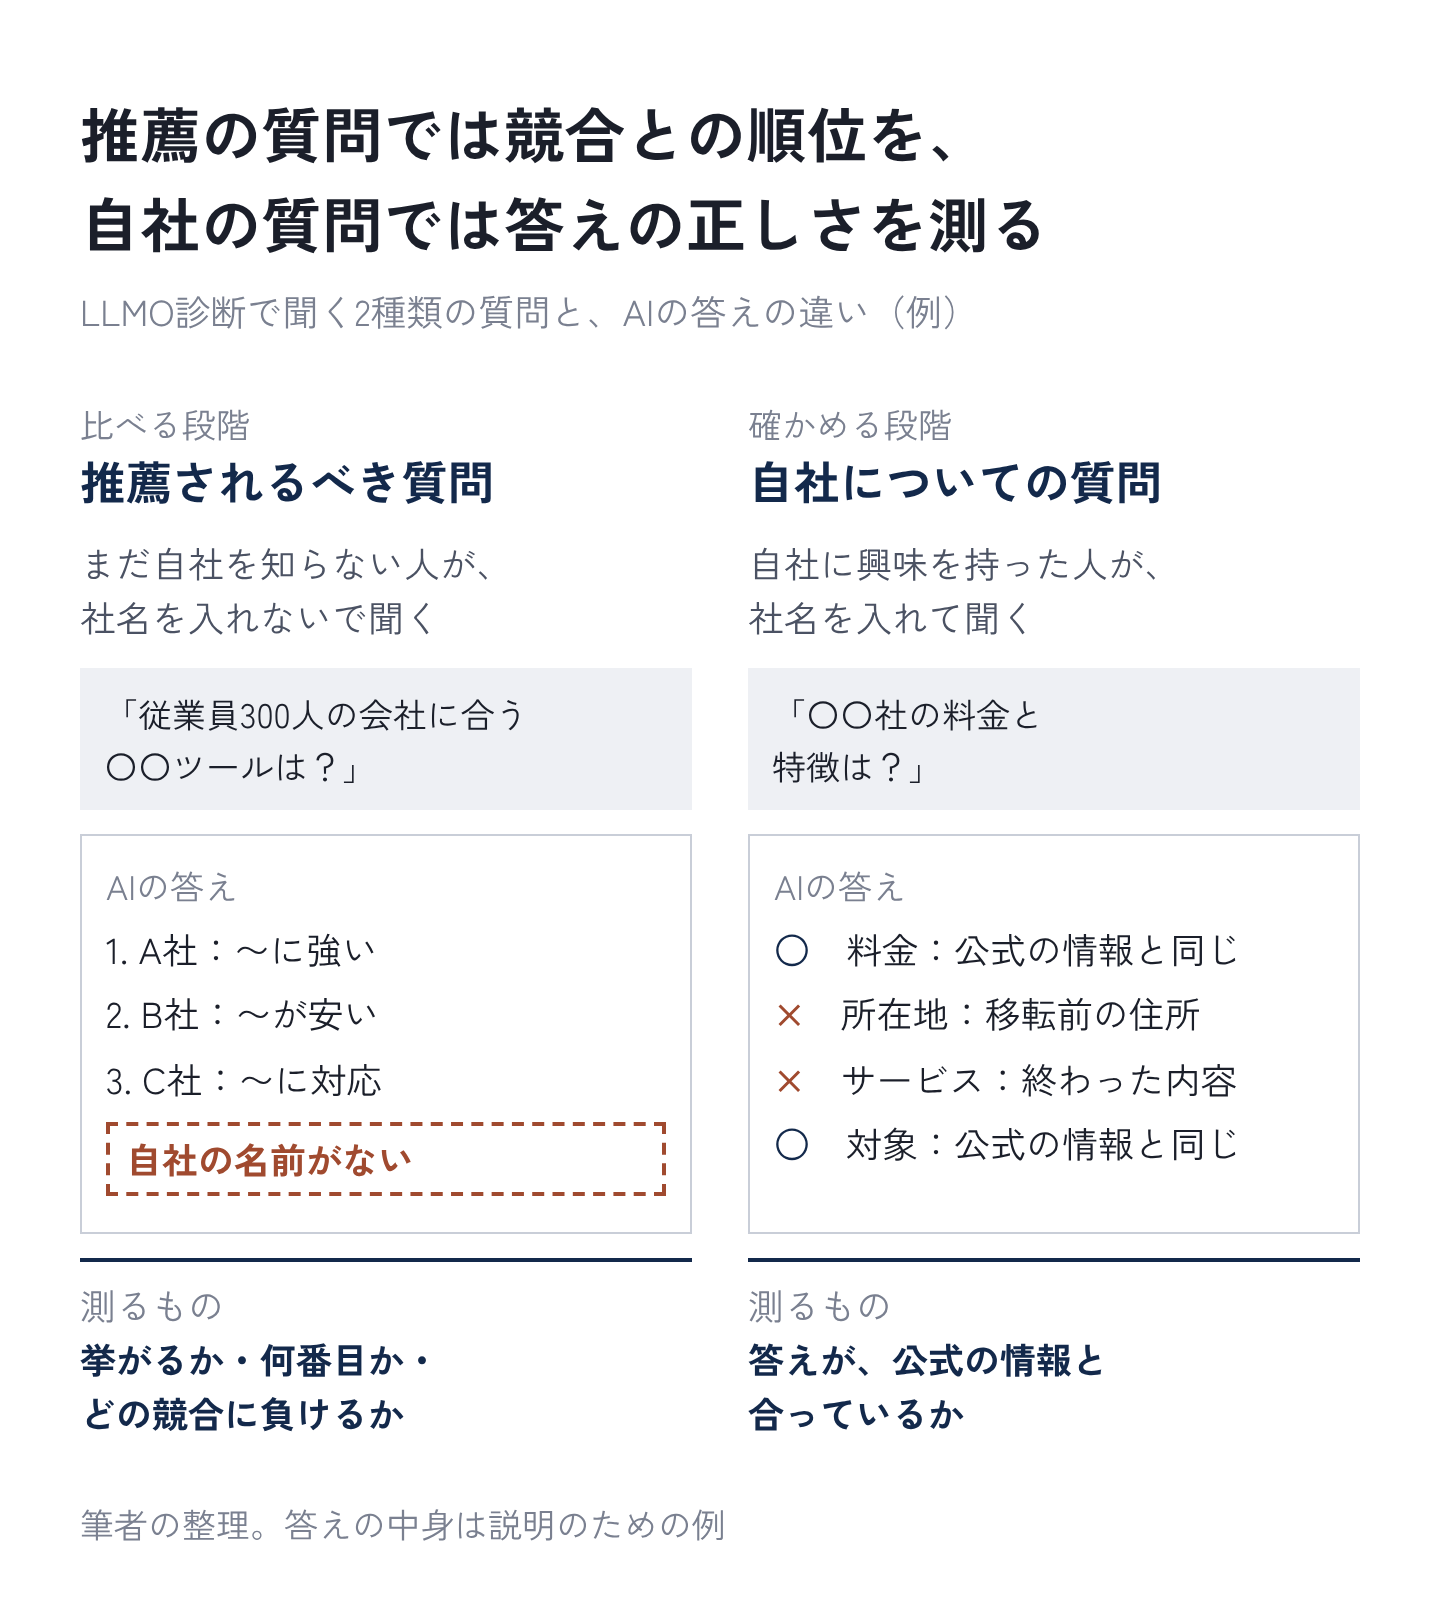
質問は、聞く人がどの段階にいるかで2種類に分けます。
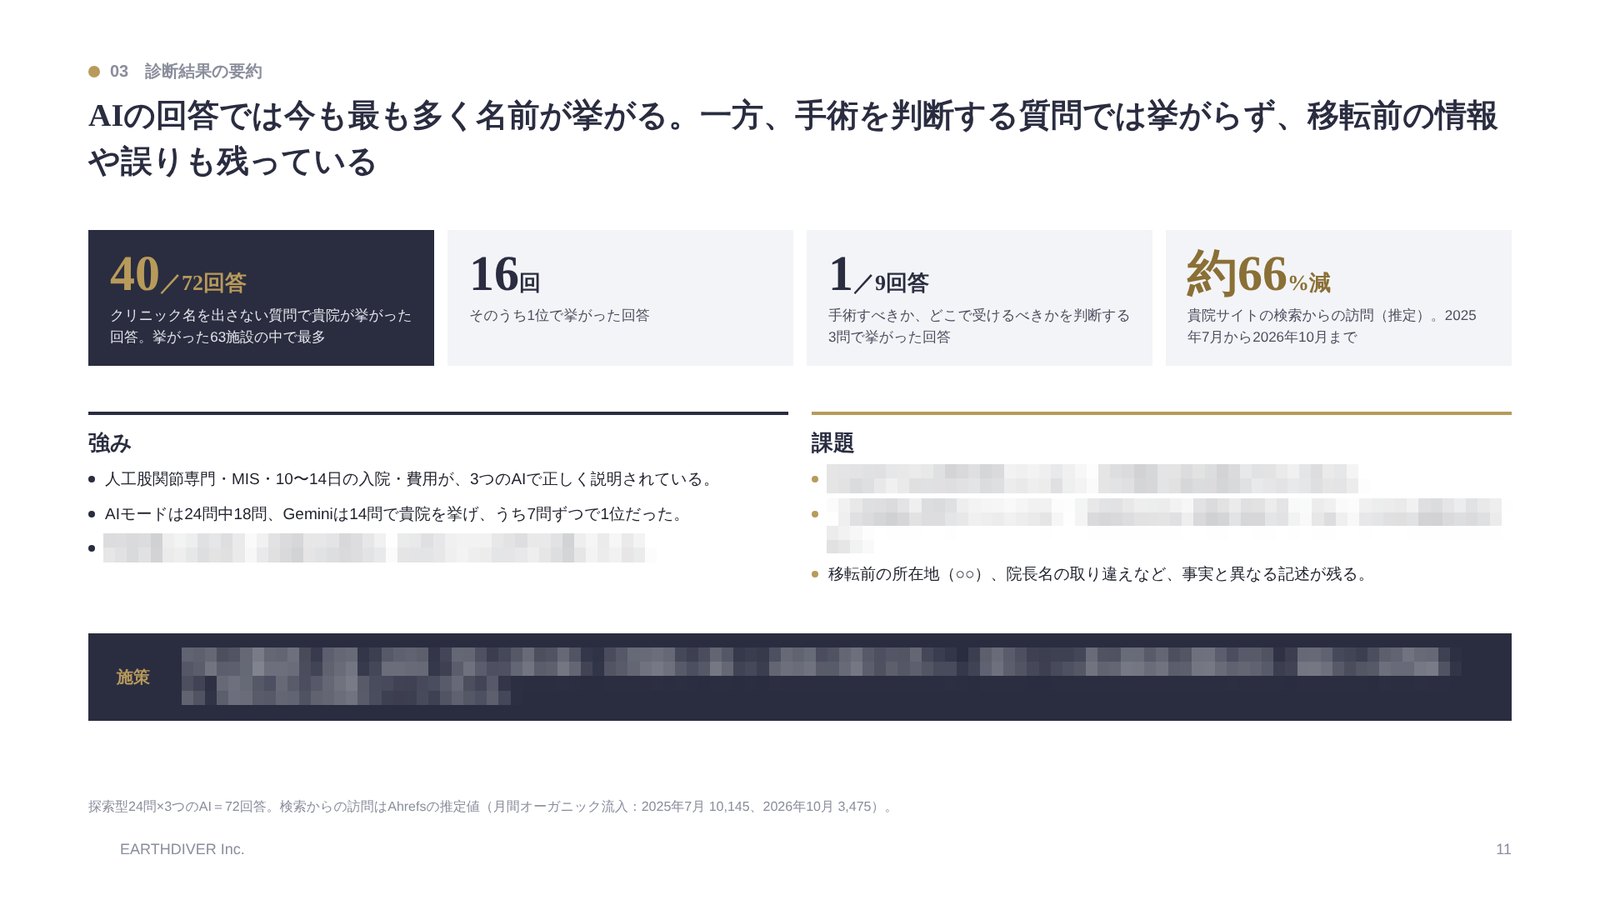
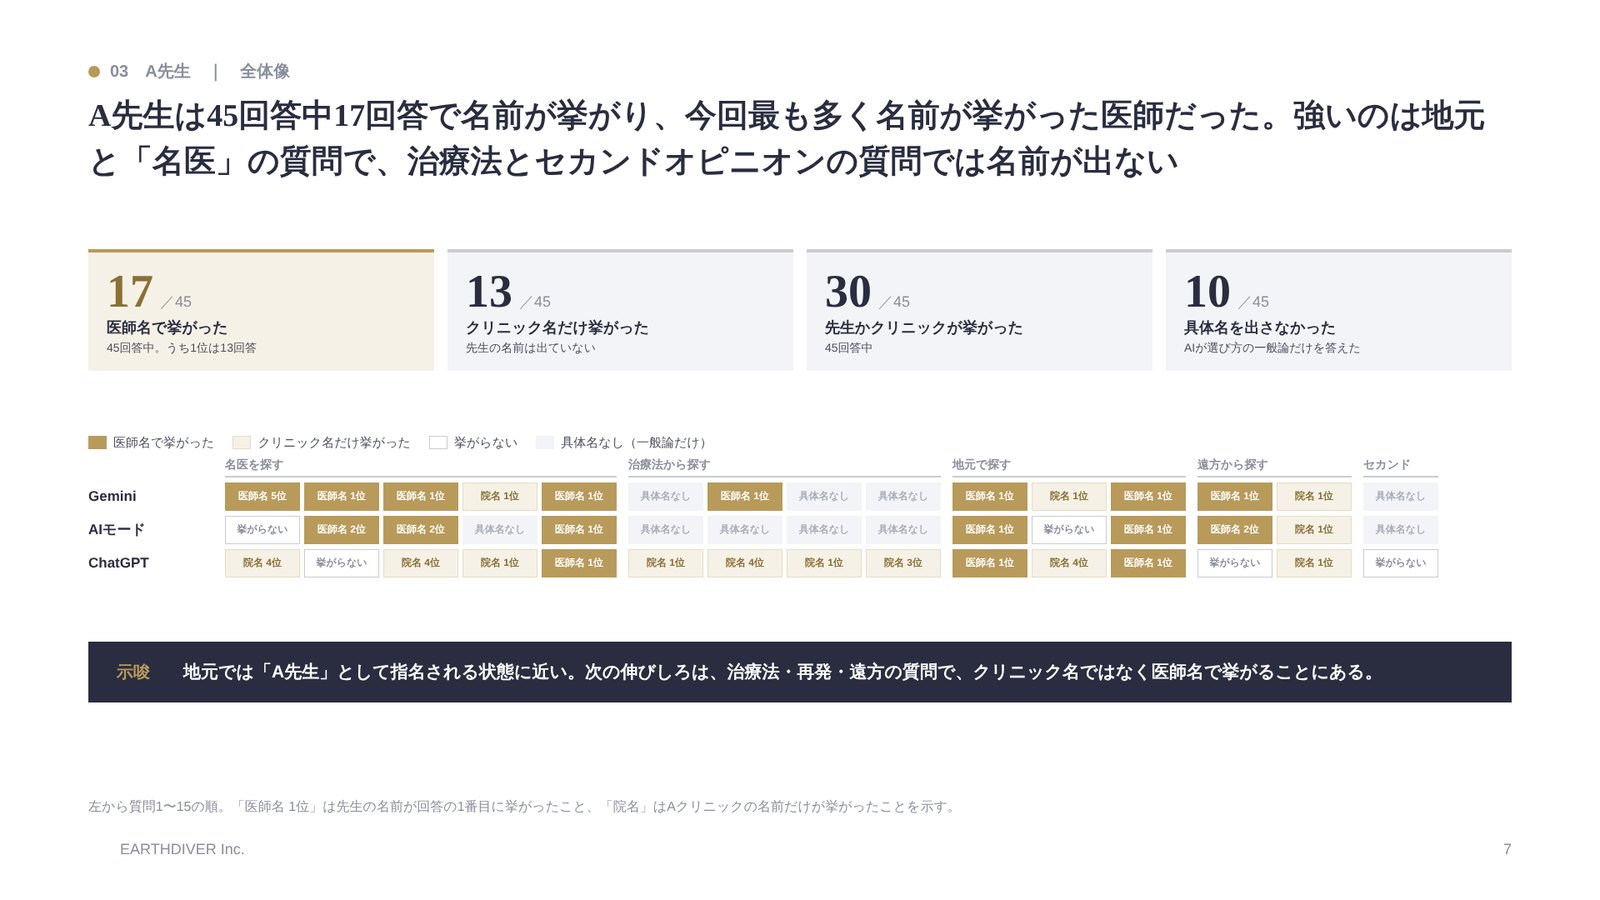
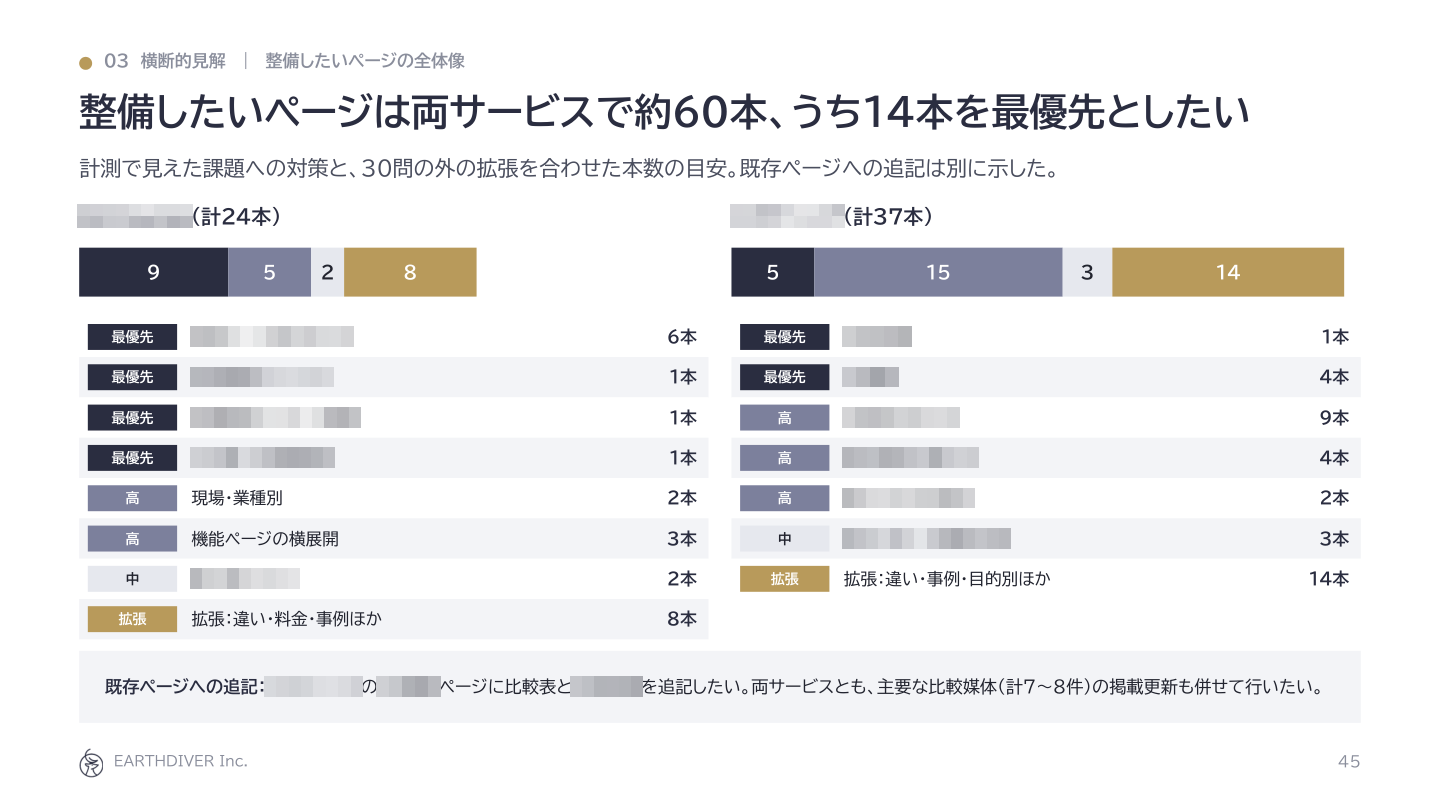
診断でお渡しするレポートの例
実際にお渡ししたレポートの一部です。社名・院名・医師名は置き換え、固有の情報にはモザイクをかけています。質問ごとの結果、並ぶ競合、AIが読んだ出典、直すページと順番までをまとめます。
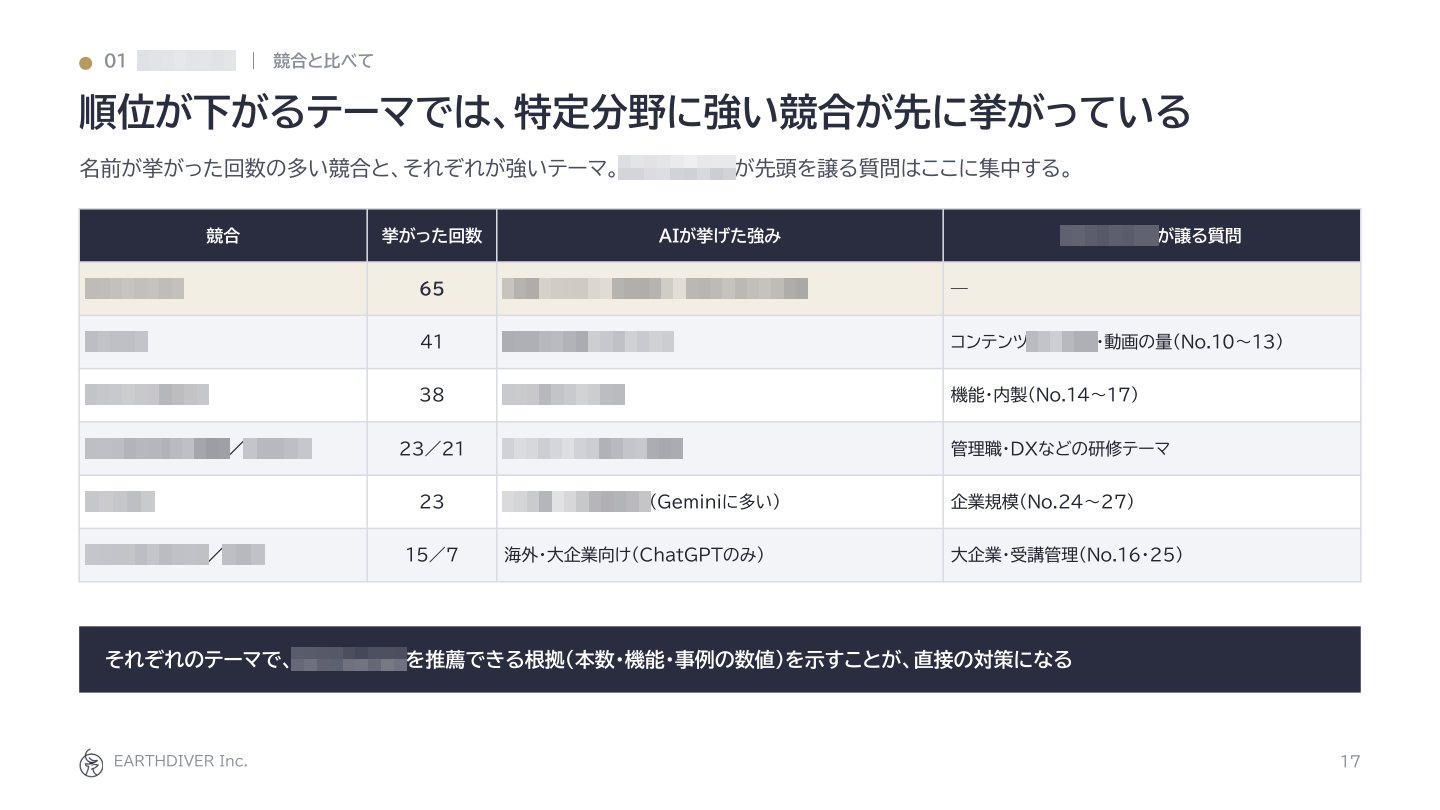
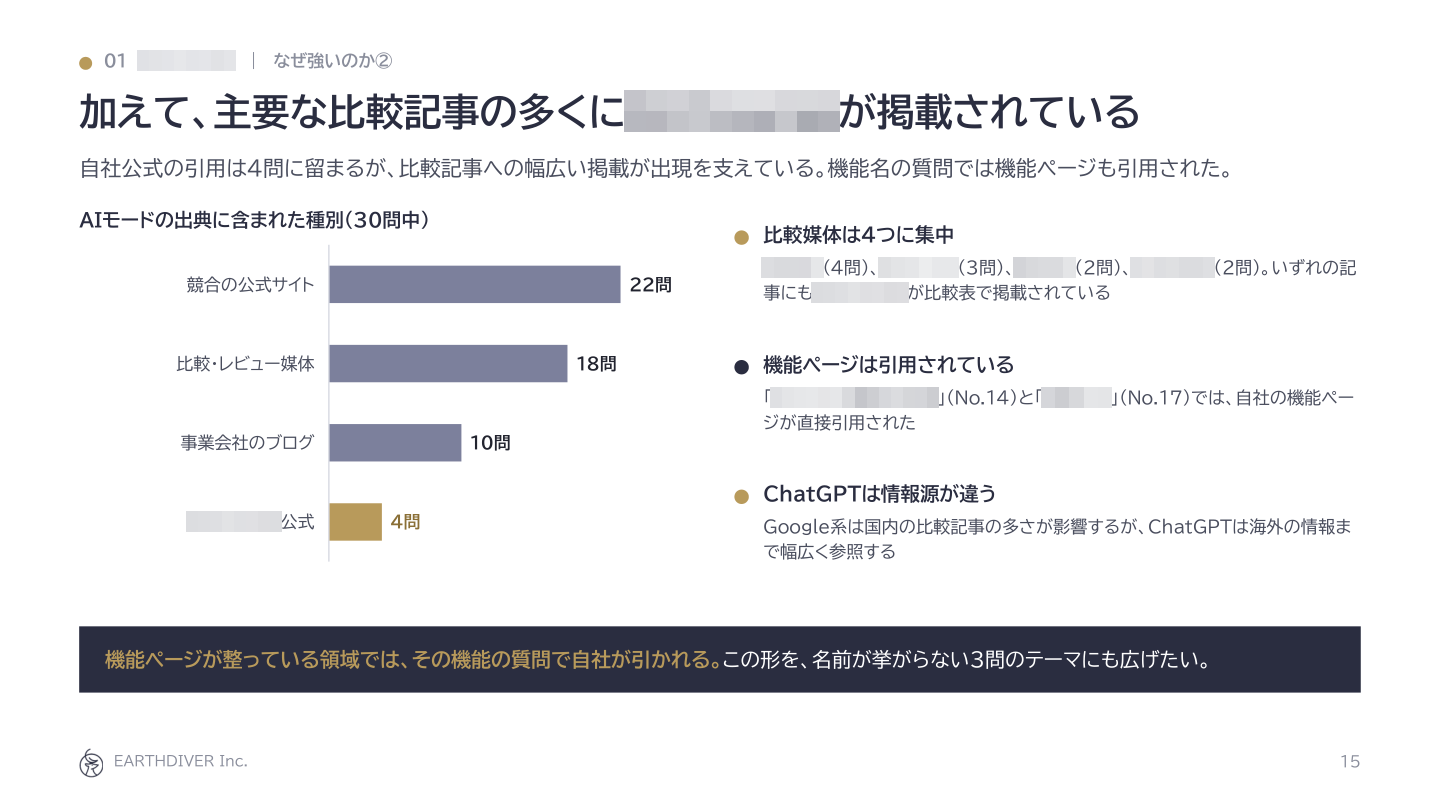
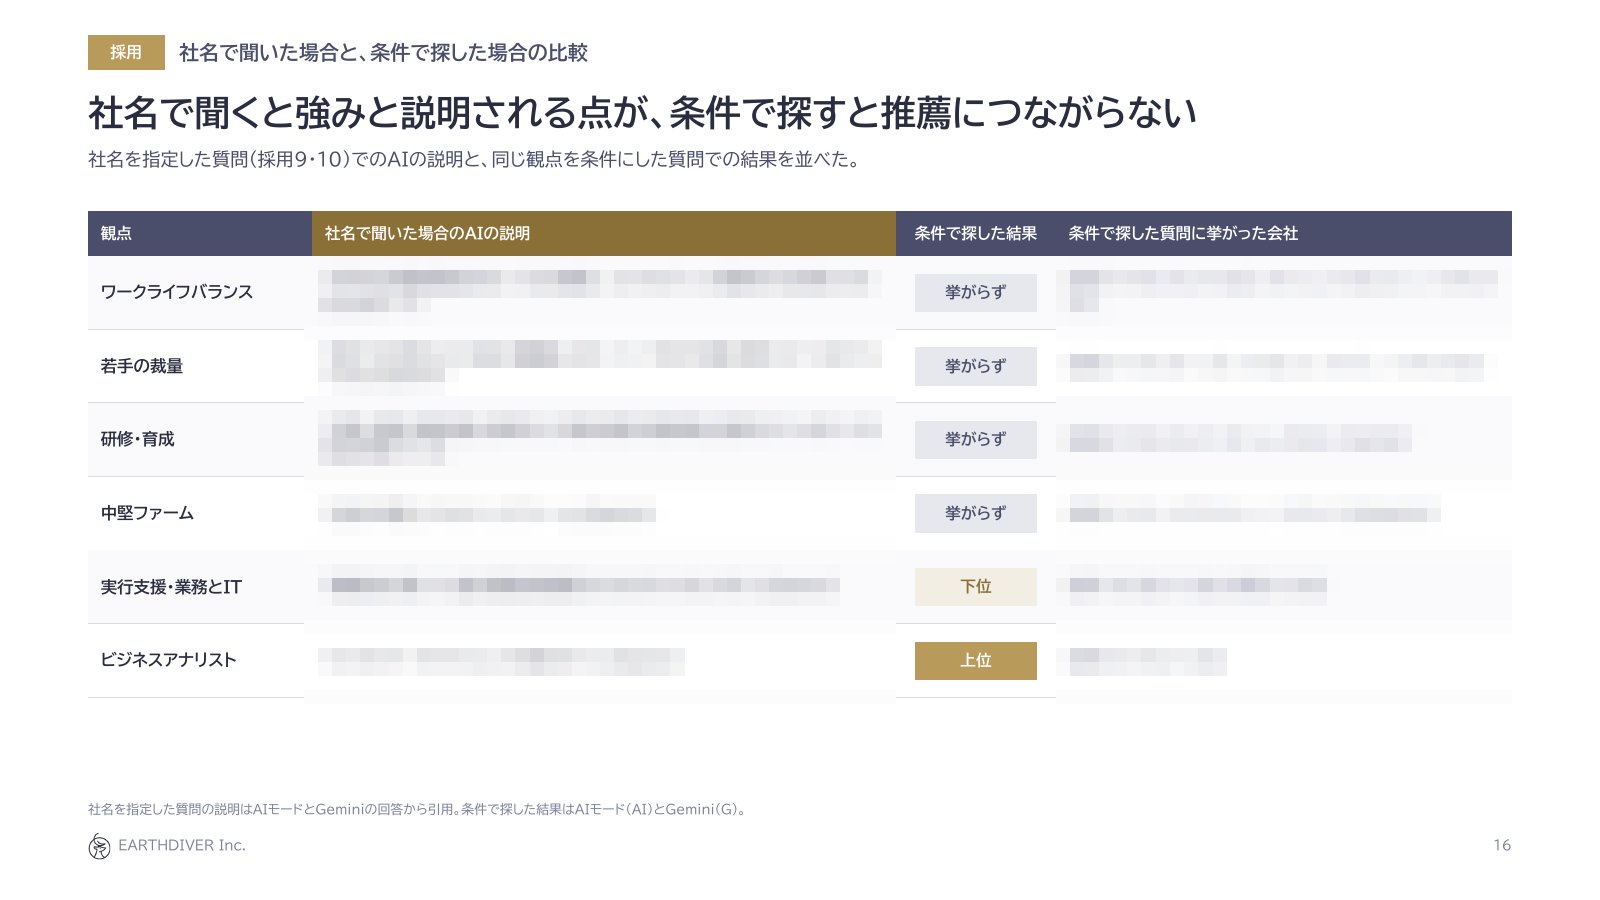
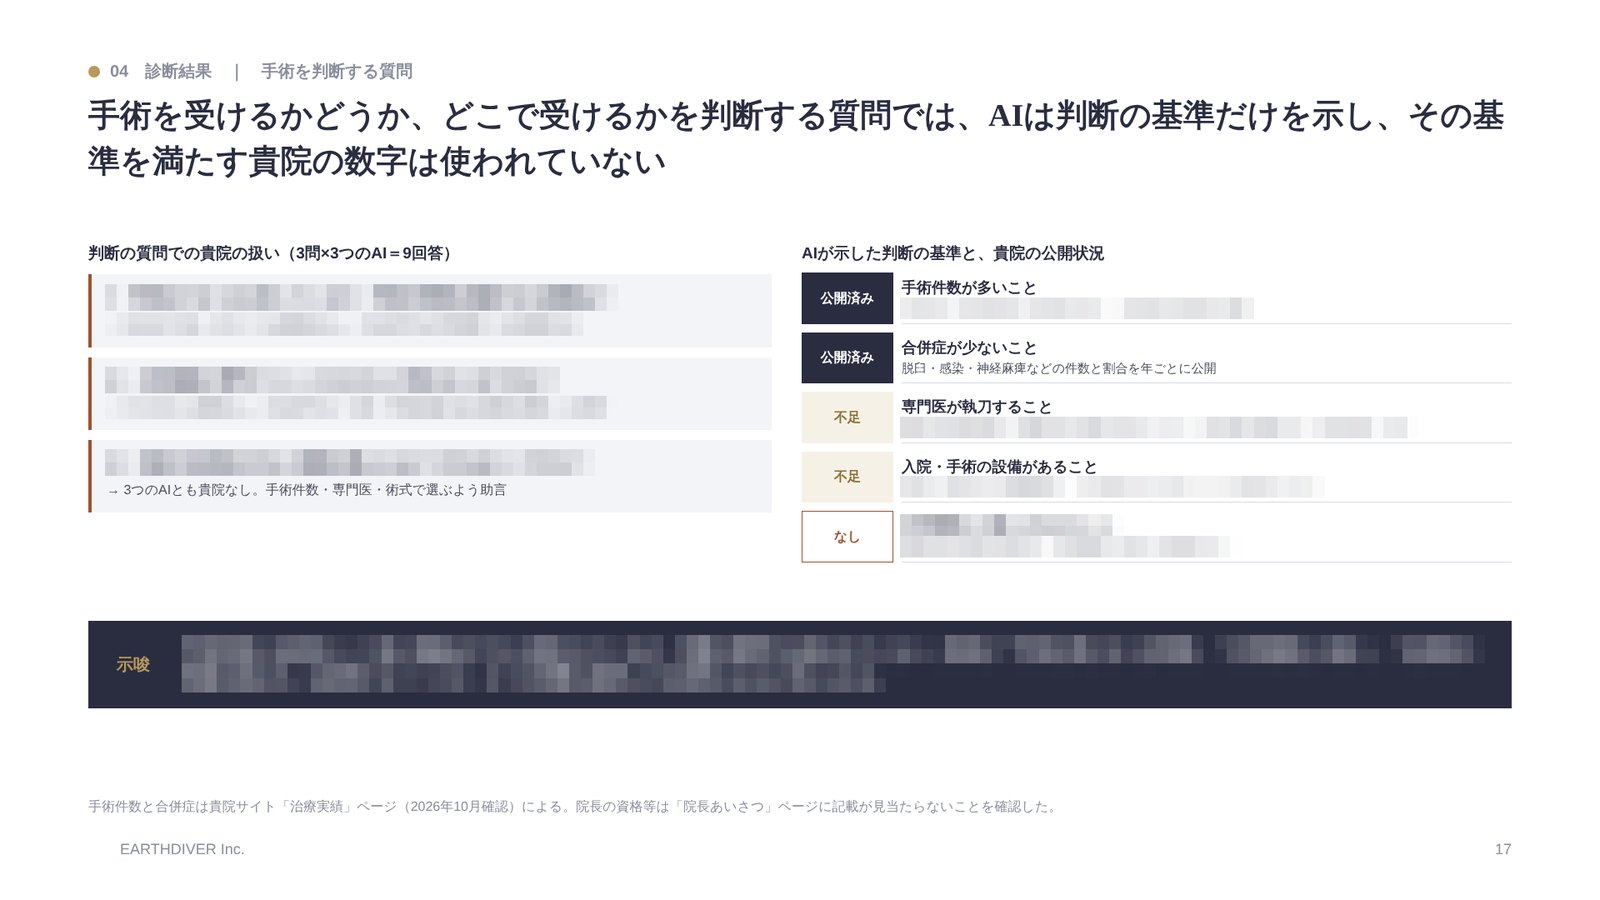
弊社の診断の3つの特長
診断の流れ
- STEP 1ご相談知りたいこと、競っている相手、伝えたい強みを伺い、合う診断を決めます
- STEP 2質問の設計相手が実際に聞く質問をつくり、ご確認いただきます
- STEP 3計測3つのAIの画面で、質問ごとに答えと出典を記録します
- STEP 4分析とレポート挙がり方・並ぶ相手・出典・説明の正誤を分析します
- STEP 5ご報告結果をご説明し、直すページと順番をご相談します
ご相談の前に、よくいただく質問
AIの答えをどう測るかで、診断の結果も、直すべき点も変わります。ツールの数字の何が問題で、どう測る必要があり、弊社がどう測っているかを、順にお答えします。
Q1市販のLLMOツールの数字では、だめなのですか?
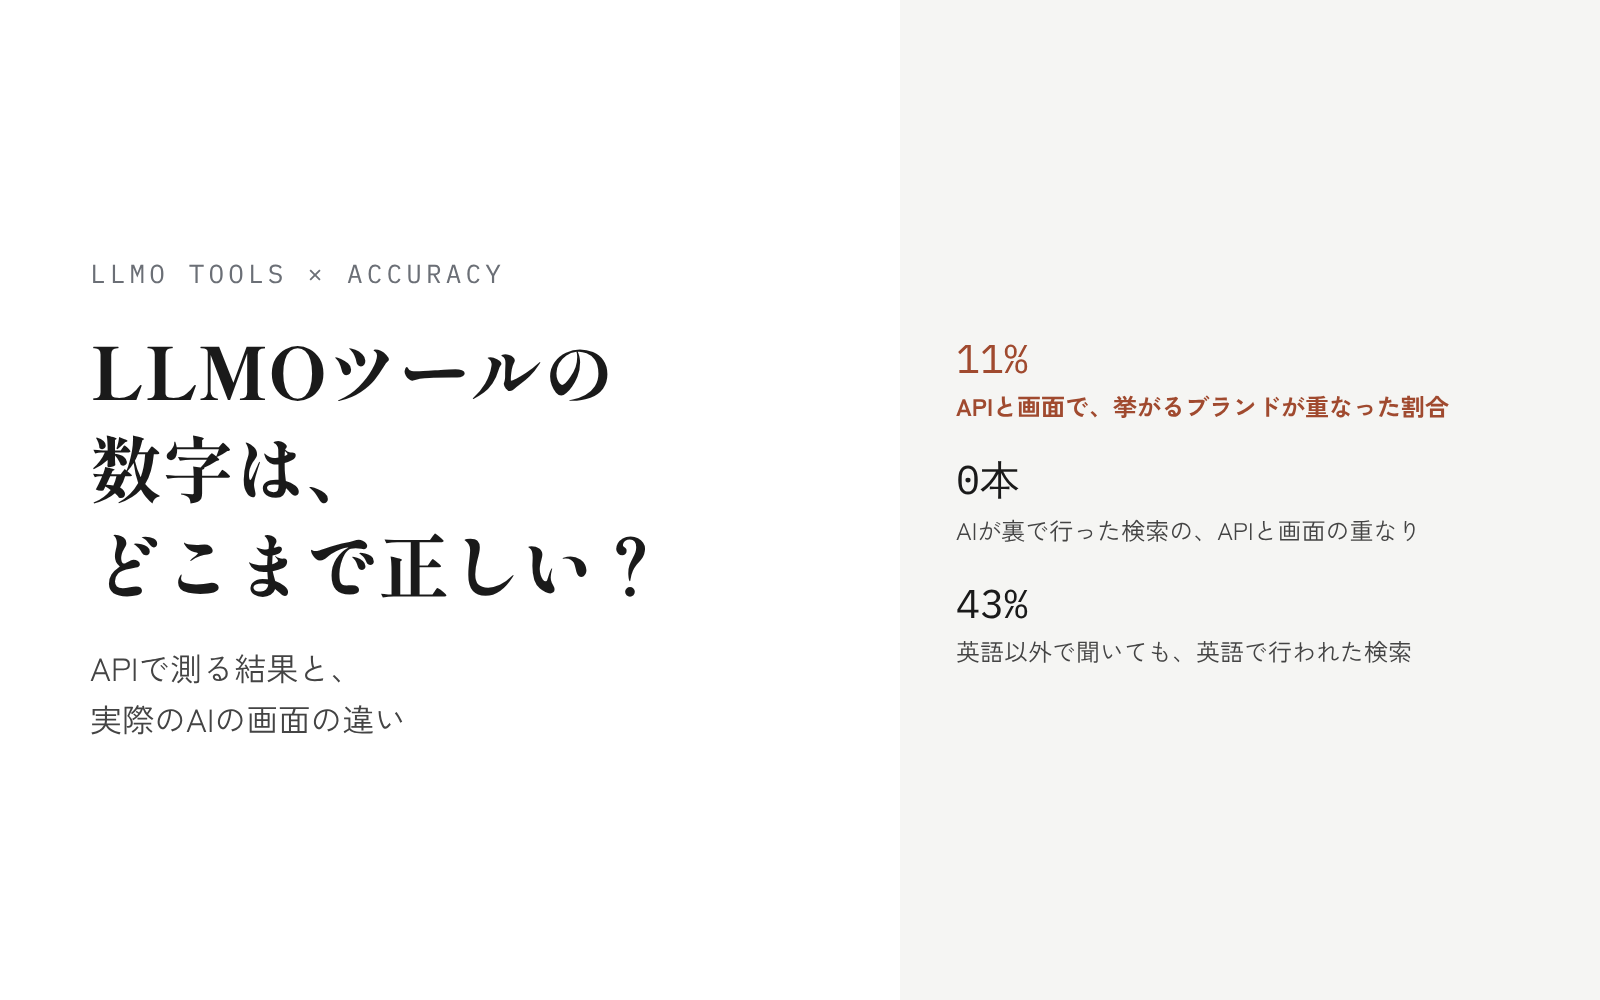
多くのLLMOツールは、APIというプログラム向けの窓口からAIの答えを取っています。ところが、APIの答えは、お客様が画面で見る答えと大きく違うことがあります。Brandlightの調査では、同じ質問をAPIと実際の画面で聞いたとき、挙がったブランドの重なりは、ChatGPTで11%、Geminiで12%でした。Genezioの調査では、ChatGPTが答える前に裏で行った検索の言葉が、APIと画面で1本も重なりませんでした。ツールの数字は、増えたか減ったかの方向を見る目安としては使えますが、お客様が見ている答えそのものとして扱うのは危険です。くわしくはLLMOツールの数字は、どこまで正しい?で解説しています。
Q2なぜ、APIと画面で答えが変わるのですか?
聞くときの条件が違うからです。地域を指定しないAPIでは、利用者を米国にいるものとして扱った例が報告されています。ほかにも、検索を使うかどうか、使うモデル、利用者ごとの記憶の有無など、APIでは画面と同じにそろえきれない部分があります。日本語で、日本のお客様の答えを知りたいときほど、この違いが大きくなりやすいと考えています。
Q3では、どう測れば、お客様が見ている答えに近づきますか?
お客様と同じ画面で、同じ条件をそろえて、何度も測ることです。AIの答えは聞くたびに変わり、SparkToroの調査では、同じ推薦の質問で同じ顔ぶれのブランドが返ってきたのは1%未満でした。1回の答えや1問の順位で判断しないで、質問の数とAIの数を重ねて、挙がる割合で見る必要があります。
Q4アースダイバーの測り方は、何が違いますか?
お客様が使うChatGPT・Gemini・GoogleのAIモードの画面で、ログインしない状態のまま、1問ごとに新しい画面を開いて手で質問を入れます。答えの全文と出典をすべて記録し、1つのAIで30問なら3つのAIで90回答を、人が読んで判定します。挙がった割合や順位に加えて、説明が事実と合っているか、AIがどのページを根拠にしているかまで確かめるので、何を直せば答えが変わるかを具体的にお出しできます。
Q5手作業で、十分な数を測れますか?
1回の診断では、15〜30問を3つのAIに聞いた45〜90回答をまとめて見ています。1問ずつの「出た・出ない」で判断しないで、AIごと・テーマごとの割合で傾向を見るためです。変化を細かく追いたい場合は、毎月などの定点の計測と組み合わせます。
Q6どの診断を選べばいいですか?
知りたい相手で選びます。お客様や取引先からの見え方なら事業、就活生や転職者なら採用、患者が病院を探す場面なら病院・クリニック、医師を探す場面なら医師の診断です。迷う場合は、初回の無料相談でお話を伺い、合う診断と質問の組み方をご提案します。
Q7いくつかの診断を、組み合わせられますか?
できます。たとえば、30問を事業20問・採用10問に分けたり、病院を探す質問と医師を探す質問を組み合わせたりして、まとめて測ることもできます。
Q8診断のあと、改善まで頼めますか?
できます。レポートでお出しした指針をもとに、ページの設計や原稿づくり、外部サイトの情報の修正まで、ご要望に合わせてお手伝いします。施策のあとは、同じ質問で測り直して変化を確かめます。
Q9結果が変わるまで、どのくらいかかりますか?
ページを公開・修正してから、AIの答えに反映されるまでには時間差があります。弊社では、施策を始めてから3か月後と6か月後に、同じ質問で測り直すことをおすすめしています。